Citation
Hongtai Zeng, Chao Yang, Yanzhen Zhou, Cheng Yang, and Qinglai Guo, “GLinSAT: The General Linear Satisfiability Neural Network Layer By Accelerated Gradient Descent,” Advances in Neural Information Processing Systems (NeurIPS), 2024.
Paper · OpenReview · Code
Abstract
GLinSAT is a differentiable neural-network layer that maps model outputs to solutions satisfying bounded general linear constraints. It reformulates the projection as an entropy-regularized linear program, converts the constrained primal problem into a smooth unconstrained dual problem, and solves it using an adaptive accelerated gradient method without matrix factorization. Gradients can be obtained either by differentiating through the iterations or by implicit differentiation with a conjugate-gradient solve. The method is evaluated on constrained traveling-salesman, graph-matching, portfolio-allocation, and unit-commitment tasks.
Introduction
GLinSAT 是一个可以将任意神经网络输出 映射到满足线性约束的可行解 的可微映射. 其核心是将原始的线性规划问题 (LP) 转化为一个对偶问题, 并使用 Nesterov 加速梯度下降法求解对偶问题, 从而得到原始问题的最优解.

Figure: GLinSAT as a differentiable feasibility layer between a neural network and the downstream loss.
Methodology
Reformulation of the neural network output projection problem
首先考虑一般的约束问题.
-
对于神经网络输出 , 我们希望通过可微的方式将其进行规范化, 使得规范后的结果 满足如下可能的约束条件:
-
其中 , , 分别是线性约束的系数矩阵, , , 分别是线性约束的右端向量, 和 分别是变量的下界和上界. 并且假设这个问题是可行的.
通过标准化的处理手段引入 slack variables , , 可以整合为如下标准形式的线性约束 (故后文默认采用标准形式):
- 这里, 作者使用内积 衡量 GLinSAT 的输出 与输入 的相似性.
- 注意, 文中同时将这个内积叫作 projection, 但是其有别于欧氏投影 (). 因此内积的核心是让输出 尽量遵循 给出的各个分量的分数排序偏好, 但不要求输出 与输入 在数值上尽量接近.
因此理论上, 我们可以直接考虑如下的 LP 问题:
- 然而一个比较显式的问题是, 对于 LP 问题, 其最优解 并不一定是唯一的, 并且通常取在线性约束的多面体构成的顶点 上. 因此, LP 事实上是在执行一个 argmax 操作 即一个分段线性函数. 故这样的映射 是一个几乎处处梯度为 0, 在分段点处不可微的函数, 这对于神经网络的反向传播是一个很大的障碍.
因此, 作者在这里提出了 entropy regularization 进行光滑化处理, 得到的正则后的目标函数为:
- 对于这个目标函数的理解如下.
-
由于 , 因此得到归一化变量 .
-
对应的标量函数 (延拓定义 ) (注意到其恰为 Bernoulli 的负 entropy)
其二阶导 , 因此 是一个严格凸函数, 且在 处取得最小值 . 其图象如下所示.
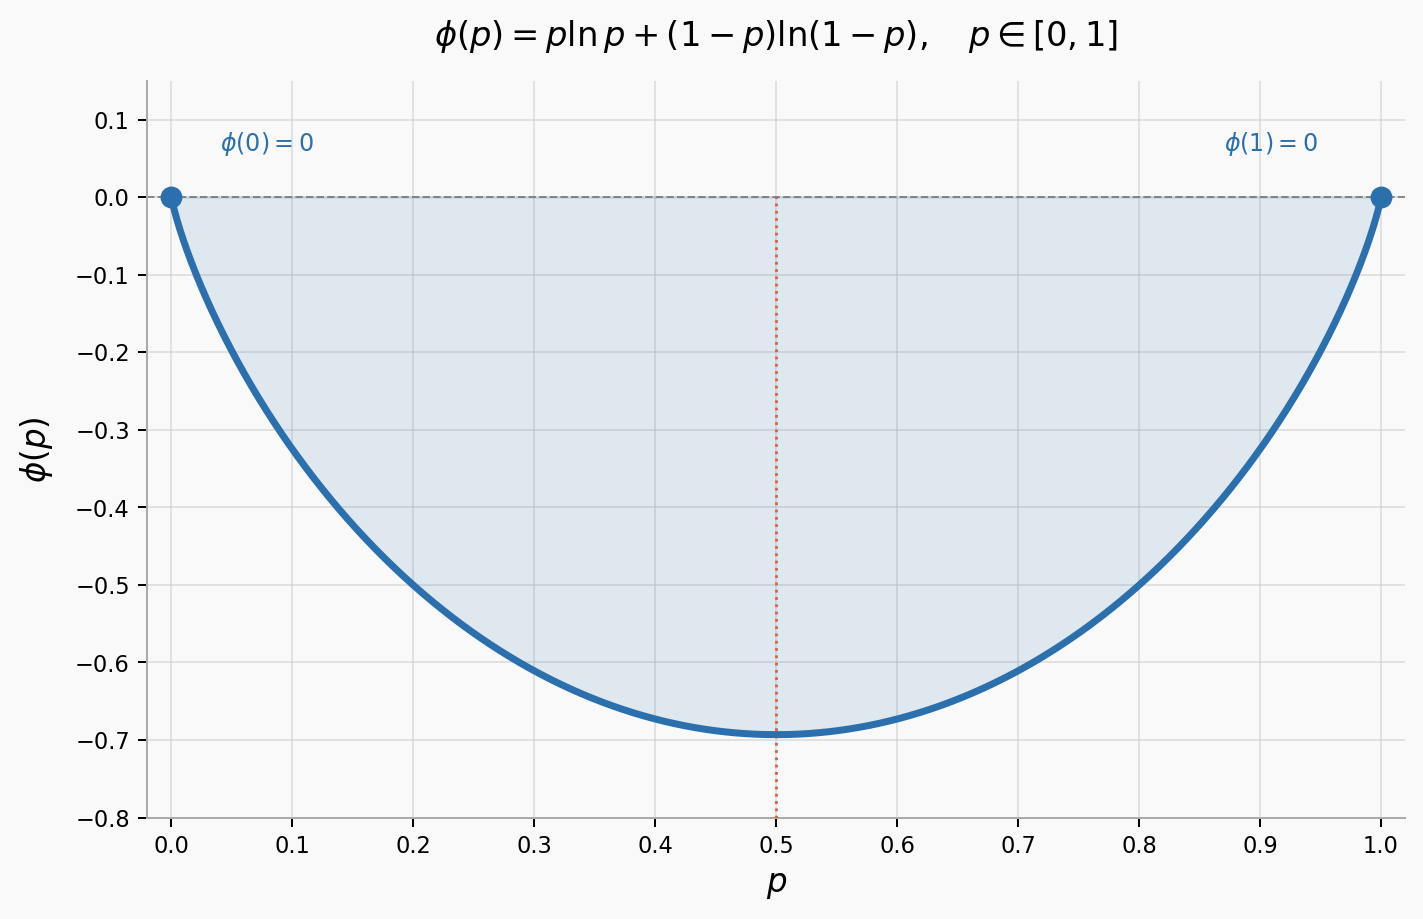
Figure: The Bernoulli negative entropy regularizer favors smooth interior solutions. 则正则项可以表达为:
也由于 的特性, 这个正则项会鼓励每个 尽量接近 , 也就是鼓励每个 尽量接近 , 即将 推向内部的平滑解.
-
若只考虑一维的情况, 则目标函数为
可以给出对应的最优 closed form solution:
其中 是 sigmoid 函数. 另外, 观察到 的作用类似于 temperature (严格说是温度的倒数), 控制了得到的输出的平滑以及均匀程度,具体而言:
- 当 , 则 , 即恢复到原始的 argmax 的非光滑解. 故 越大, 则越接近原始的 LP 解, 但是梯度也越不稳定. (注意, 当 LP 非退化时, 该逼近方才成立)
- 当 , 则 , 由 entropy 直接得到区间中间的正则解. 故 越小, 则越接近平滑解 (越平均), 但是偏离原始的 LP 解也越远.
-
接着, 我们先暂时只考虑 的等式约束, 将不等式 box-constrain 暂时作为定义域的限制. 逐步考虑其对偶问题.
-
引入 Lagrangian Multiplier , 则对应的 Lagrangian 为:
- 其中 表示逐元素除法, 表示逐元素乘法, 表示全 1 向量.
-
对应的对偶函数为:
-
其内层最小化问题
-
注意到其全部都是逐分量求和的, 且分量间彼此解耦, 故可以独立对每个分量求最小值. 故考虑标量函数
其一阶导数为
且有, , . 又根据其二阶导数
由此可知, 是严格凸函数, 且在区间 内部有唯一的最小值, 且对全部 都成立.
-
对于每个分量的最小值, 由一阶导数为零的条件可得
故用向量整合, 则为:
-
-
在成功求出内层最小化问题 后, 则可以将其代入对偶函数 中, 得到
因此, 对偶问题可以写为:
又根据原函数和对偶函数的关系, 可以证明 是 Lipschitz 光滑的, 因此所有梯度下降法都可以用来求解这个对偶问题.
- 这里强调, 对于内层问题求出的解 , 其是
的最小值. 其求解过程保证了 box-constrain 是一定可以被满足的. 然而对于等式约束 , 其仍然是在 Lagrangian 中被当做惩罚项处理的, 因此 并不一定满足等式约束 .
- 只有当 取到最优解 时, 才能保证 满足等式约束 . 理由如下:
- 原问题的 Lagrangian 为: . 对偶问题为 . 由对偶问题的最优性条件可知, 而又根据 的最优性条件, 则有 因此对于最优解 , 有 , 即 满足等式约束 .
- 只有当 取到最优解 时, 才能保证 满足等式约束 . 理由如下:
- 这里强调, 对于内层问题求出的解 , 其是
的最小值. 其求解过程保证了 box-constrain 是一定可以被满足的. 然而对于等式约束 , 其仍然是在 Lagrangian 中被当做惩罚项处理的, 因此 并不一定满足等式约束 .
-
Forward pass in GLinSAT
由上面的推导, 我们得到对于神经网络的输出 , GLinSAT 需要向前传播得到满足约束的 . 而该约束已经转化成了一个对偶问题, 其形式为:
其中 是一个 Lipschitz 光滑函数, 且其梯度为
故笼统地讲, GLinSAT 的前向传播过程即为:
故下面的核心是如何高效地求解对偶问题 .
-
已知 是一个 Lipschitz 光滑函数, 且其梯度为 , 其中 . 故对任意 , 有
- 其中, 最后一个不等式是根据 sigmoid 的性质: 得到的. 故 是一个 Lipschitz 光滑函数, 且其 Lipschitz 常数为 .
-
给定 的 convex & Lipschitz 光滑性质, 因此可以使用 Nesterov 型的 primal-dual 梯度加速方法 (AdaptivePrimalDualAcceleratedGradientDescent) 对这个目标函数进行优化, 以得到 的收敛率.
-
之所以不使用 vanilla NAG, 是因为我们的本质期待还是高效的求解 primal 问题 . 因此我们在对 进行优化的过程中, 同时要维护一个 的优化序列, 使得对于对偶问题的加速求解能够有效转化为 primal 问题的加速求解. 此外 Adaptive 这里是说我们在每次迭代中, 通过某种 linesearch 方法, 得到一个更为适配的符合当前迭代函数的 Lipschitz 常数 (记为 ), 以便更快地收敛 (而不是使用全局保守的 Lipschitz 下界).
-
下面具体讨论一下 GLinSAT 的 Nesterov 加速算法. 其主体同样采用三阶段的 Nesterov 加速方法:
-
其中, 是对偶问题的加速序列, 是对偶问题的梯度下降序列, 是进行梯度计算的查询点. 其都是在对偶空间中完成的. 真正的 primal 变量是通过 来计算的.
-
是 Nesterov 的加速参数, 是步长参数, 其可以通过某种 linesearch 方法自适应地选择.
-
初始化时, 令 , . 且 . 以及 Lipschitz 常数 . 额外两个加速过程的迭代参数, .
-
算法最终的停止条件为
-
首先, 计算 , 其为如下二次方程 的正根, 即
并接着定义
通过上述的定义方法, 恒有如下等式成立, 其是 Nesterov 加速方法推导的核心:
该表达式在迭代中始终被满足.
-
接着, 计算加权系数 , 其为
-
然后, 计算查询点 , 其为
-
然后计算查询点对应的 primal 变量 , 其为
以及梯度信息
-
然后更新对偶变量 , 其为
-
然后更新对偶变量 , 其为
若将上述更新过程进行合并整理, 可以得到
-
最后, 进行自适应的尝试更新 Lipschitz 常数 . 观察上面的等式, 是更新的步长. 如果 太大, 则步长太小, 更新过于保守. 因此我们需要随着迭代的不断进行, 不断尝试得到一个更小更为准确的曲率系数 , 以得到更为合理的步长. 事实上, 我们进行尝试的选择依据就是 . 将具体的迭代点代入, 最终的 linesearch 的条件可以化简整理为:
也就是我们本身是希望 选择的越小越好, 但是如果当前步骤不满足上述条件, 则说明 选择的过小, 则将该 double, 直到满足上述条件为止. 然后再下一轮的时候再尝试选择一个更小的 (取 half), 以便更快地收敛.
- 当然在实践中还会有一些工程参数, 例如额外引入 tolerance 阈值 . 当 时, 说明当前 仍然过小, 应拒绝该次尝试并增大 . 当充分下降条件连续成功两次时, 才正式尝试更新 . 这样可以避免过于频繁地更新 而导致不稳定.
-
-
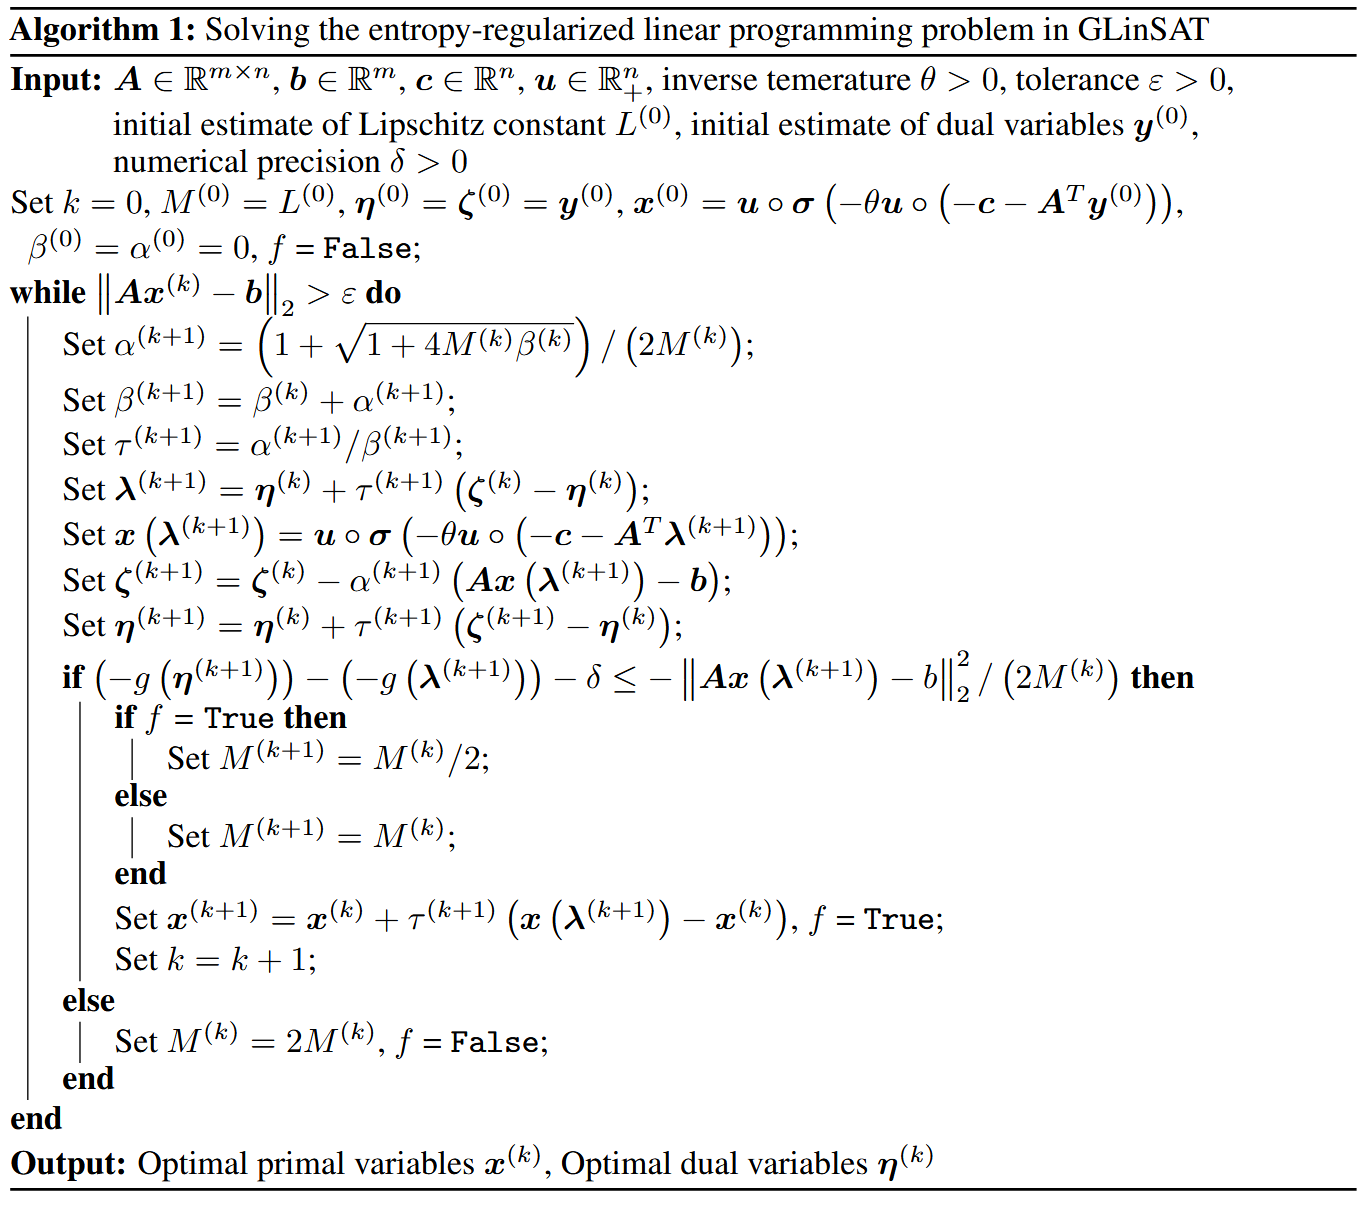
Figure: APDAGD updates the dual variables while maintaining an averaged primal solution.
上述的迭代复杂度为
- 越大, 意味着 entropy regularization 越弱, 输出更接近原始 LP 的极点解; 但同时对偶目标的光滑常数变大, forward pass 更难求解.
Backward pass in GLinSAT
整体而言 GLinSAT 在模型 pipeline 中的作用如下.
若将 GLinSAT 内部再进一步拆开, 则可以得到如下的流程图:
因此, 在 backward pass 中, 我们需要计算 .
AutoGrad
一种简单的方法就是自动调用 PyTorch 等深度学习框架进行自动的反向传播, 由于注意到在我们求解 GLinSAT 内部时, 要进行 次的 APDAGD 迭代, 尽管这个迭代过程本身全部是可微的, 但若 unrolling 展开的话会极大的增加计算图的复杂度, 使得反向传播的计算量和显存消耗都非常大.
CG-based Backward
更为经济的做法是探究最终最优点处的模型结构, 利用模型的相关数学方程结构来帮助推导.
-
回顾, 优化的对偶目标为
且
在最优点处, 根据 , 则有
并且在最优点处满足 .
-
因此, 在最优点处, 我们有一个隐函数关系 . 根据隐函数定理, 我们可以对 关于 求导, 得到
其中可以分别代数求得
以及
因此最终得到的
-
因此再代入更完整的计算图中, 从 出发, 最终得到的损失函数的梯度关系为:
故代入隐式微分结果, 有
不过在论文中还进行了一个更 generalized 的处理. 其若允许对偶变量 也和 一样, 直接参与到损失函数中, 则最终的梯度公式为:
若想还原回原始的 不参与损失函数的情况, 则只需要令 即可.
-
在得到理论的梯度传播公式后, 我们还需要考虑如何高效地计算这个 VJP. 故我们可以将其转化为一个线性方程组求解问题, 其形式为
从上述线性系统中求解出 . 其中 , 而列向量 已在上式定义.
-
由于 , 故将具体的表达式代入整理, 则上述线性系统 LHS 的系数为
-
且 是对称半正定的. 若进一步 是行满秩, 则是对称正定的. 因此可以使用 CG 方法高效求解该线性系统, 以得到 . 这是因为, 上面我们展示了, 是对称正定的, 因此求解 就等价于求解 QP
而这样的方法就很适合使用 CG 方法.
-
Conjugate Gradient (CG) 方法是求解对称正定线性系统的经典方法. 其基本思想就是沿着共轭方向去进行搜索迭代, 而共轭方向可以简单理解为由 诱导的正交方向. 其具体迭代过程如下:
- 初始化 , 初始化残差 , 初始化搜索方向 . 即第一步沿着负梯度方向进行搜索.
- 在第 步迭代中, 当前迭代点为 , 搜索方向为 , 步长为 , 我们希望沿着直线 进行搜索, 使得 最小化二次函数 . 故可以求得第 步的步长为 进而以此更新迭代点 更新残差
- 检查迭代停止条件
若满足, 则停止迭代, 否则继续迭代, 更新搜索方向:
- 这里 是 CG 方法中用于构造共轭搜索方向的系数; 在精确算术下, 新方向与此前搜索方向在 诱导的内积下保持共轭.
-
可以看到, 通过引入 CG 方法, 我们完全摒弃了矩阵求逆, 而是化成了一系列的矩阵乘法. 而且中间的 还是对角矩阵, 其实质上进一步被简化为标量乘法. 计算量被大幅简化.
-
Experiments
Predictive Portfolio Allocation
对于 predictive portfolio allocation 问题, 模型的目标是最大化 Sharpe ratio, 同时保证输出满足线性的资产配置约束. 其总体 pipeline 如下:
其中 是投资组合的权重向量, 并假定如下约束:
- 资金全部投入, 即 .
- 给定偏好资产集合 , 以及配置权重下限 , 要求偏好资产配置份额不低于 , 即 . 文中取 .
- 不允许做空或杠杆, 即 .