Citation
Qi Deng, Yuxuan Linghu, and Zhiyuan Liu, “Integrated Prediction and Multi-period Portfolio Optimization,” arXiv:2512.11273, 2025.
Abstract
This paper studies multi-period portfolio optimization as a decision-focused learning problem. Instead of training a return predictor only for forecast accuracy and then passing forecasts into a downstream optimizer, IPMO trains the predictor through the portfolio objective itself. The model uses multi-period return forecasts to parameterize a differentiable mean-variance optimization layer with turnover penalties, then learns from realized portfolio performance. Its main computational device is a mirror-descent fixed-point differentiation scheme, which avoids directly factorizing KKT systems and keeps implicit-gradient computation scalable as the planning horizon grows.
Problem Background
Multi-period Portfolio Optimization (MPO)
在当前时刻 , 投资者当前持有 portfolio 权重 (即为 long-only portfolio), 其中 是投资 universe 中的资产数量. 此时, 要规划未来 个离散时间点的一系列 portfolio 权重 , 或以矩阵形式表示为
在当前信息集 下, 投资者的目标是最大化未来 期的条件期望效用:
- 是当前时刻 的信息集, 包含了投资者在时刻 可用的所有信息.
- 是整个 allocation path 的效用函数, 其中 可能包含 expected portfolio return, portfolio risk, transaction cost 等多个方面的因素.
这里进一步给出 time-separable structure 的效用函数的定义, 以便后续的分析. 其将负效用函数(之期望)定义为:
- 是时刻 的 portfolio performance function, 刻画该期静态的资产表现, 例如 expected return, variance 等.
- 是时刻 的 dynamic trading function, 刻画根据资产的 portfolio adjustment 所产生的 rebalancing cost, 例如 transaction cost, risk due to trading 等. 是一个权重参数, 其取值越大, 对于 portfolio adjustment 的惩罚越大, 因此投资者在进行 portfolio rebalancing 时会越谨慎.
具体地, 这里将 定义为经典的 MPC mean-variance objective function, 即
- 是时刻 对未来时刻 的资产 return 的预测.
- 是时刻 对未来时刻 的资产 return covariance matrix 的预测. 其作为 covariance matrix 是 symmetric positive definite 的. 注意到, 由于 , 因此 是一个 strongly convex function.
- 是 risk aversion parameter, 其取值越大, 投资者对于 portfolio risk 的 aversion 越强.
对应的, 将 定义为对于 turnover 的 smoothed penalty, 即
- 是 smoothing parameter.
- 当 时, ; 在 附近, , 故在 附近, 类似一个 quadratic function.
- 其导数为 , 且 , 因此 是一个 smooth convex function.
- 时, . 整体函数类似于 penalty, 不过同时其 curvature 更强, 对应数值 condition 可能更差.
综上, 完整的优化目标函数就可以写为
其中 是 portfolio 权重的可行域, 是对于 turnover 的 smoothed penalty.
Receding-horizon Model Predictive Control (MPC)
首先展示我们的多期预测与传统的贪心预测的区别. 简而言之, 在当前时刻 进行交易的时候, 传统的贪心预测方法只会关心 和 来指导下一期的投资. 然而, 在多期决策的框架下, 我们会同时考虑未来 期的预测 和 来指导当前时刻 的投资决策. 一个并不严谨的例子, 类似于可以以更长期的预测视野进行”提前布局”, 从而在未来的投资过程中获得更好的表现.
不过需要指出, 在 MPC 的框架下, 虽然在时刻 会有整个未来 期路径的决策:
然而实际在执行的时候, 只有 会被真正交易, 其余的 都是 “虚拟” 的决策. 之后在时刻 , 投资者会根据新的信息集 来重新进行 MPC 的优化, 从而得到新的未来 期的路径决策:
因此也叫做 receding-horizon MPC.
Traditional two-stage approach: Predict first, optimize second
下具体考虑一个两阶段的预测与优化的 pipeline. 具体约定符号如下. 定义 为截止至 时刻的过去 天的 只资产的 return matrix. 为未来 期的 只资产的 return matrix.
首先进行预测.
-
建立机器学习预测模型 来预测未来 期的 return matrix , 通过如下 prediction loss 来训练模型参数 :
- 是 prediction loss function, 例如 mean squared error (MSE), mean absolute error (MAE) 等.
- 是模型的 regularization term, 例如 regularization, dropout 等. 是 regularization parameter.
-
然后进行决策.
- 在日期 , 一次性预测出未来 期的 return matrix , 其中 是通过上述 prediction loss 训练得到的模型参数. 并估计出 covariance matrix (例如通过 sample covariance estimator, factor model 等方法).
- 之后将预测结果 以及 covariance matrix 的预测 作为输入, 来求解 MPC 的优化问题 , 从而得到未来 期的 portfolio 权重路径 . 之后在时刻 进行交易, 只执行 .
这是非常典型的在 decision-focused learning 中讨论的两阶段的预测与优化的解耦失配问题.
IPMO Learning Framework
Problem Formulation
对于每个训练时点 同样考虑输入 和输出 , 以及对应的 portfolio 权重路径 和预测模型 .
然而这里的预测模型之输出
虽然形状和传统的预测模型 一样, 但其并不追求最小化与真实未来 return matrix 的 prediction loss. 该预测值不会被直接评价, 而是进入一个 multi-period portfolio optimization 的优化问题中 (即上述 ), 从而得到一个关于权重路径 和预测 的目标函数 , 得到对应输出:
具体地, 这里的 可以定义为平滑后的 MPC objective function, 即
在得到 之后, 才会再用 和真实的未来 return matrix 来计算一个 decision-focused learning 的 loss:
来衡量最后决策的表现.
因此, 总的而言, 其可以形式化写作如下 bi-level optimization problem:
或具体化为:
本质上, 传统先预测后决策的方法求解的是
而 IPMO 则是直接求解
Bilevel Optimization Problem
对于这样的双层优化问题, 其整体的数据流如下
其中 是求解 MPC 优化问题 的 solution mapping:
因此总的 loss function (forward pass) 可以写为
对应的 backward pass 则为:
对于传统的 Bi-level 优化方法, 通常通过对 lower-level optimization problem 的 KKT condition 来求解 , 从而得到整个 loss function 的 gradient. 然而这对于一般的矩阵形式是非常复杂的.
Mirror Descent
在本文的 framework 中, 由于需要求解 , 其需要限制 , 其中 是 simplex.
故对于这样的有约束 optimization problem, 可以通过 mirror descent 来求解. 下简要对 MD 进行介绍. 这里暂时不考虑 MPC 的复杂优化函数, 而只单纯考虑一个 general 的含 simplex 约束的 optimization problem, 即
回顾一般的 Gradient Descent , 其事实上等价于
Mirror Descent 则是将上述的 distance 换成一个 general 的 Bregman divergence, 其更适合 simplex 这样的约束空间:
其中 要求是 strictly convex, 其必须在可行域的相对内部可微. 并且希望整体的更新是 closed-form 的, 从而可以高效地求解. 这里定义为 negative entropy function, 即 . 其对应的 Bregman divergence 就是 KL divergence, 即
因此最终得到的 MD 的更新为
下进一步具体求解这个 MD 更新的 closed-form solution. 其等价于优化过程:
通过求解 Lagrange multiplier, 可以得到其 closed-form solution 为
这相当于进行一个含温度的 softmax 更新, 其中 基本就是 softmax 的 temperature.
因此, 我们展示, 当我们要处理一个 simplex 约束的 optimization problem 时, 使用由 negative entropy 作为 mirror map 的 MD 方法, 可以得到一个 closed-form 的更新, 并且更新规则恰为一个 softmax 更新, 这样的更新将天然地满足 simplex 约束. 这对于我们求解 MPC 的 optimization problem 是非常有用的.
Theorem: 设 可微且 strongly convex, 则对 的最优解 是 Mirror Descent 的一个固定点, 即 .
Proof. 对于全局最优解 , 其满足 first-order optimality condition, 即 . 因此考虑 MD 的更新公式
其中这里的两项, 都有性质 和 且都在 时取到最小值 . 因此其最小值恰好在 处取得, 从而 是 MD 的一个固定点.
Implicit Differentiation of MD Fixed Point
在 IPMO 中, 我们要求解的内层优化问题为:
对这个具体的优化问题应用上述的 MD 方法, 则其更新为
这里我们将整个 MD 的更新过程定义为一个 operator (回顾 是 portfolio 权重的 simplex 约束空间), 其相当于是在完整 期 horizon 的完整更新:
其中, 对于某时间点 ,
其中对于某资产 , 其更新为
换言之, 在第 次迭代中, 对于时刻 的资产 , 其权重的更新为
至此, 我们成功地建立起 的 closed-form solution, 并且根据 Fixed Point 定理, 可以得到:
故可以通过 implicit differentiation 来求解 :
进一步, 在实践中, 注意到这里需要求解一个 的矩阵的 inverse. 若记 , 则其 Neumann series expansion 为
不过需要满足收敛条件: , 其中 是 的 spectral radius, 即所有特征值的绝对值的最大值:
在实践中通过控制步长 不要过大来保证.
因此完整的更新可以写为
其中 是一个 predefined 的 truncation level. 并且事实上这样的更新也可以进一步通过反复的 Jacobian-vector product 来高效地求解.
IPMO Pipeline
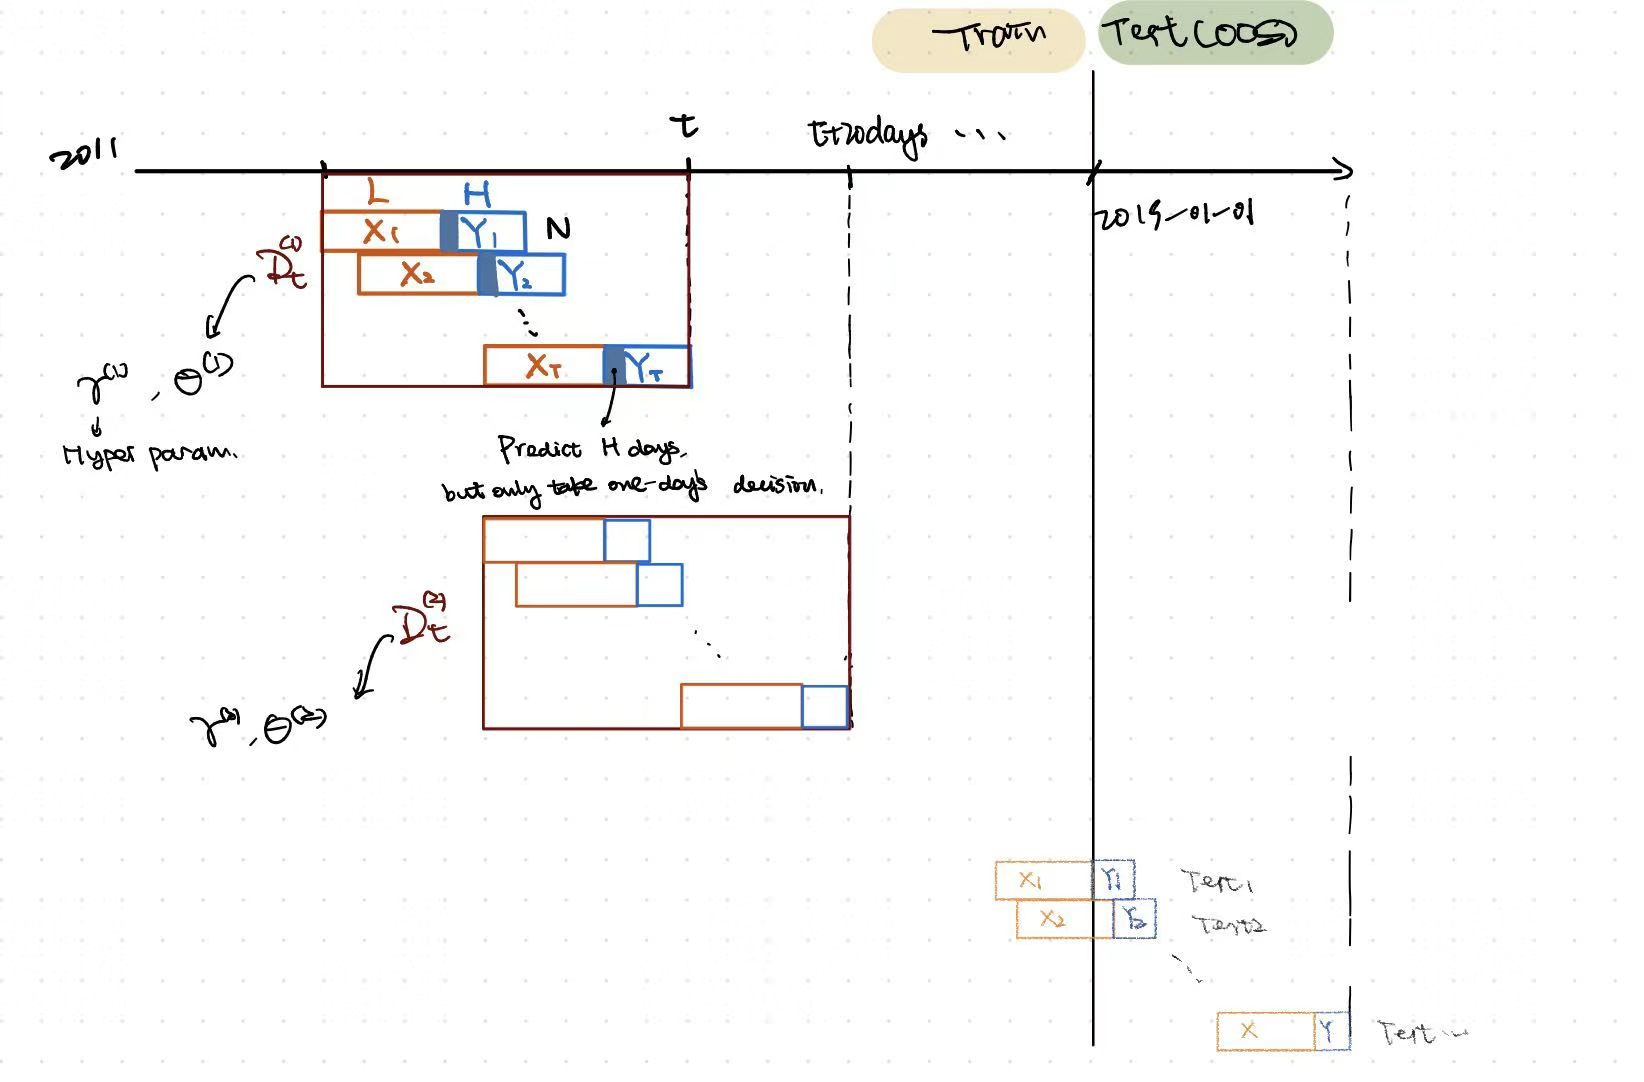
下面完整的在开发视角落实 IPMO 的框架.
-
数据集构建
- 给定 支 ETF 资产的日度收益率 , 时间范围为 2011
2024 年. 这里取 20112018 年为 in-sample, 用于参数训练与超参数选择. 给定 2019~2024 作为 out-of-sample, 用于模型评估. - 对于每个训练日期 , 构建一个输入输出对 , 其中 是过去 天的日度收益率, 是未来 天的日度收益率. 其中 , , 为训练集大小. 因此一个完整的训练集即为 其中 是训练集的索引. 这里需要说明, 每个 都是一个完整的数据集, 用这 期的 来训练一个预测模型 . 因此, 对于每个训练集, 我们都能得到最终的一套参数, 以及超参数设置.
- 每两个相邻的训练集之间相隔 天, 不同的训练集类似于查看在不同 scenario 年景下的模型表现. 在实践中, 真正的作用是通过多期的数据集进行超参数选择. 因此其作用类似于时间序列版的 cross-validation.
- 给定 支 ETF 资产的日度收益率 , 时间范围为 2011
-
训练细节
- 对于每个具体的训练集 , 其将运行 IPMO 的算法. 具体流程如下.
Experiments
数据集
-
资产:7 个主要资产类别的 ETF
- 股票:VTI, IWM
- 债券:AGG, LQD, MUB
- 商品:DBC
- 贵金属:GLD
-
时间段:
- 2011–2018 年用于 in-sample / 超参数调优
- 2019–2024 年用于 out-of-sample 测试
-
输入特征:
- 每日历史收益 (过去 L=120 天)
- 目标输出 (未来 H 天)
- 协方差矩阵 用过去 20 天的 EWMA 简单估计,并加 εI 确保正定
预测模型
-
RLinear:
- 单层全连接网络,独立建模每个资产
- 历史 5 天收益做均值以缓解噪声
- L2 正则化
-
CNN-LSTM:
- CNN(64 个 channel,kernel=5,stride=1,ReLU),max-pooling kernel=2
- LSTM 两层,hidden size=64
- 所有资产共用池化层
- Reversible instance normalization 处理分布漂移
-
训练策略:
- 预测未来 H 天收益
- 滚动窗口训练:过去 250 天,每 20 天重新训练
- 学习率 .
- Turnover penalty .
- Horizon .
- 两阶段 (TS) 与 IPMO 框架均使用 Sharpe 和 turnover 选择超参数
内层优化
- IPMO 内层:
-
目标:多期均值-方差加交易成本惩罚
-
平滑交易成本使用
-
内层求解器:
- Forward pass:ADMM 求解多期优化 (2)
- Backward pass:Mirror-descent fixed-point (MDFP) implicit differentiation
-
Output: allocation sequence
-
只执行第一步 ,其余作为梯度传递辅助
-
外层 loss
- 外层决策损失:
- 用于训练预测模型 θ
- 通过公式 (11) 用链式法则:
实验比较
基线:
- Equal-Weighted (EW)
- Classical Mean-Variance (MV)
- 两阶段 TS + 同样预测器
实验指标:
-
收益:Annualized Return
-
风险:Volatility
-
风险调整指标:
- Sharpe
- Calmar
- Return / avg drawdown
-
Turnover
-
MSE of prediction
-
Portfolio weight trajectories(heatmap & total variation)
核心发现:
- IPMO 在所有指标上优于两阶段 TS,尤其 Sharpe、Calmar、低交易频率
- RLinear + IPMO 与 CNN-LSTM + IPMO 都优于对应 TS
- IPMO 权重调整平滑,减少了大幅波动,表现出 buy-and-hold 行为
- MSE:
- RLinear:IPMO MSE 略高,但决策质量提升(决策导向训练)
- CNN-LSTM:IPMO MSE 较高,但收益与风险指标提升,说明更好捕获多期 intertemporal structure
计算效率
-
梯度求解:MDFP vs BPQP vs CvxpyLayer
-
Table 4 & Figure 6:
- MDFP runtime 几乎不随 H 增长(0.69s 增长从小 horizon 到大 horizon)
- BPQP 线性增长
- CvxpyLayer 增长最陡
-
MDFP 利用 Neumann series 近似
-
优点:
- 内存占用低
- 大 horizon 下 runtime 几乎不变
- 可复用 elementwise Jacobian-vector products