References
- Lecture: 李政軒, https://www.youtube.com/watch?v=p4t6O9uRX-U&list=PLt0SBi1p7xrRKE2us8doqryRou6eDY
- Reading: John Shawe-Taylor and Nello Cristianini, Kernel Methods for Pattern Analysis.
- Reading: Bernhard Schölkopf and Alexander J. Smola, Learning with Kernels.
1. Basic Idea
Kernel Method 的核心思想是通过非线性映射 (Non-linear Mapping) 将原始数据映射到一个更高维的特征空间 (Feature Space), 使得在该空间中, 原本线性不可分的问题变得线性可分. 然后, 我们可以在这个高维空间中应用线性模型, 例如线性分类器或线性回归, 来处理数据.
具体地, 对于这样的线性不可分数据 , 定义一个映射函数 , 将数据点 映射到高维 Hilbert 空间 中. 此外定义一个核函数 , 用于衡量输入数据点之间的相似性, 即映射后空间中对应点的内积:
根据理论可以保证, 任意非线性可分的数据集, 只要选择合适的映射函数 和核函数 , 就可以将其映射到一个高维空间中, 使得数据在该空间中线性可分. 这使得我们能够利用线性模型来处理复杂的非线性问题.
1.1 Feature Mapping
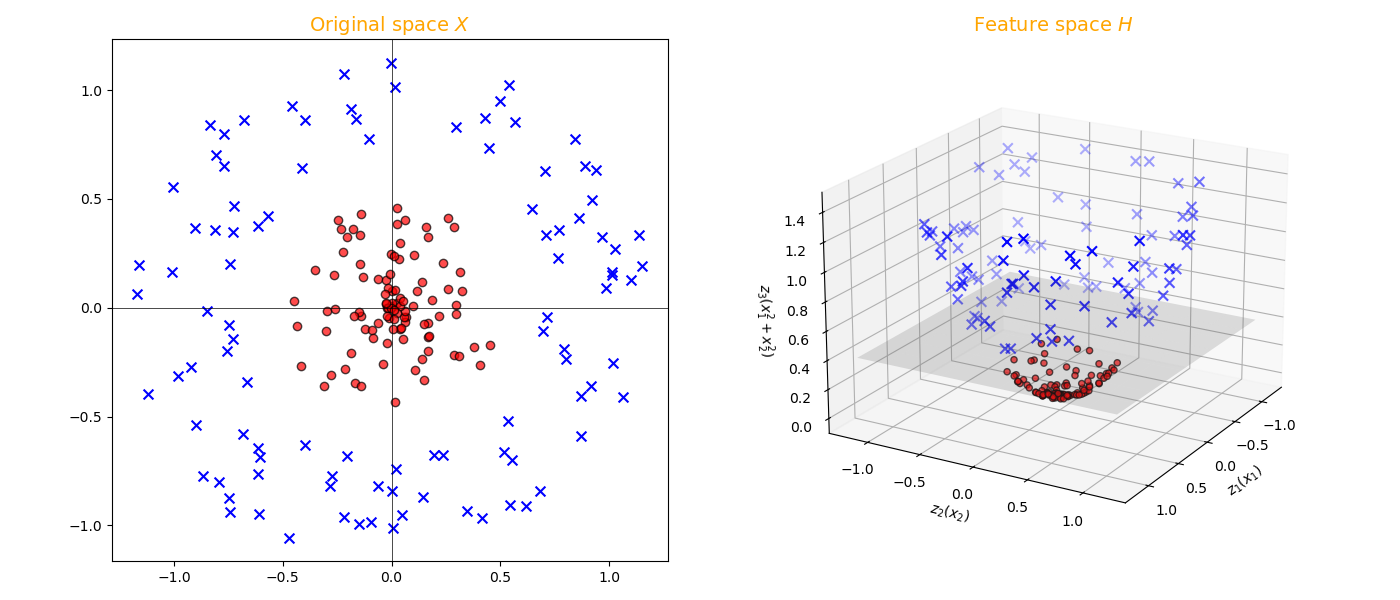
- 对于原始 空间中的数据点 , 我们需要使用非线性边界, 例如椭圆 , 来进行分类.
- 如果将数据映射到 空间, 使用映射函数 , , 则此时的椭圆形边界在新空间中变成了一个平面边界: .
- 因此, 通过适当的映射函数 , 可以将原本线性不可分的问题转化为线性可分的问题.
1.2 Kernel Function
同样以上述映射为例, 关注映射前后数据点之间的内积关系.
在原始空间中, 两个数据点 和 之间的内积为:
在映射后的空间中, 对应的两个数据点 和 之间的内积为:
不难发现, 映射后空间中的内积可以通过原始空间中的内积来表示, 简记为 . 这个函数 被称为核函数 (Kernel Function). 在本例中, 具体形式为 .
Definition (Kernel Function). 称函数 为 上的核函数 (Kernel Function), 若存在 feature mapping , 使得对于任意 ,
因此, Kernel Function 变成了高维映射 的一种替代表示. 只要知道核函数 , 就等价于知道了映射 后的内积关系. 若只关注高维空间中的内积运算, 则无需显式地知道映射 本身. 这就是核方法的核心思想.
1.3 Geometry from Kernels
即使只知道 Feature Space 中的内积关系, 即核函数, 也能推导出一些最重要的几何性质, 例如距离和角度.
Distance in Feature Space.
Angle in Feature Space.
1.4 Gram Matrix
给定一组数据点 , 可以构造一个 的矩阵 :
这个矩阵 被称为内积矩阵 (Inner Product Matrix), Gram 矩阵 (Gram Matrix) 或 核矩阵 (Kernel Matrix). 它包含了所有数据点在 Feature Space 中的内积信息, 因此可以用于计算距离和角度等几何性质.
2. Characterization of Kernels
核定理指出, 只要一个函数 满足有限半正定条件, 就存在一个映射 , 使得 . 这意味着可以通过设计合适的核函数, 来隐式地定义一个高维映射 , 而无需显式构造该映射.
Theorem (Moore-Aronszajn Theorem). 设 为任意非空集合, 若函数 是对称函数. 则下列命题等价:
-
是有限半正定核 (PSD Kernel), 即对于任意有限点集 及任意实数系数 ,
-
由 定义的 Gram 矩阵 为半正定矩阵, .
-
存在一个 Hilbert 空间 和一个特征映射 , 使得对于任意 ,
故此定理保证了, 只要设计的核函数 满足有限半正定条件, 就一定存在一个对应的高维映射 和 Hilbert 空间 , 使得 可以表示为 和 在该空间中的内积.
2.1 Commonly Used Kernels
Definition (Polynomial Kernel). 对于任意 及常数 和整数 , 定义多项式核为:
例如 , 则
对应的 feature mapping 为:
事实上可以计算出, 对于任意 维输入和 次多项式核, 对应的 feature mapping 会将输入映射到一个维度为 的空间中.
Definition (Gaussian / RBF Kernel). 对于任意 及常数 , 定义高斯核为:
Definition (Laplacian Kernel). 对于任意 及常数 , 定义拉普拉斯核为:
Definition (Sigmoid Kernel). 对于任意 及常数 和 , 定义 Sigmoid 核为:
3. Dual Representation and Kernel Trick
考虑在 feature space 中的线性函数 , 其中 , . 我们希望仅通过核函数 来表示这个函数 .
Theorem (Representer Theorem). 给定训练数据集 , 假设希望最小化以下正则化经验风险:
其中 是损失函数, 是正则化参数. 则最优解 可以表示为训练数据点在 feature space 中的线性组合:
其中 是系数.
换言之, 最优权重向量 可以完全由训练数据点的映射 线性组合而成, 即 . 这意味着可以将原始优化问题转化为关于系数 的优化问题.
将 代入线性函数 中, 可得 dual representation:
因此, 线性函数 可以表示为核函数 的线性组合, 其中系数为 .
综上, 我们可以通过核函数 来隐式地处理高维映射 , 这就是所谓的核技巧 (Kernel Trick).
4. Kernel-Based Linear Regression
给定训练数据集 , 其中 为输入特征, 为对应目标值. 给定一个核函数 , 对应的映射函数为 .
输入矩阵为:
输出标签仍为 . 假设线性回归模型为:
对应的 OLS 问题为 , 其 normal equation 为:
若 可逆, 则有闭式解:
根据 Representer Theorem, 最优解 可以表示为训练数据点在特征空间中的线性组合, 即存在系数向量 , 使得:
为了求解 , 将 代入 normal equation:
定义核矩阵 , 其中 . 则上式可写为:
对应的 normal equation 为:
若 可逆, 则有闭式解:
对于任意新的输入样本 , 其预测值为:
实践中往往通过 KRR (Kernel Ridge Regression) 来避免核矩阵 不可逆的问题, 即在目标函数中加入正则化项 :
5. RKHS and Representer Theorem
关于 RKHS, 我们最终想得到如下目标:
- 从一个核函数 出发, 构造出一个以函数为元素的 Hilbert 空间 .
- 该 Hilbert 空间 可以定义一个内积 , 使得 .
- 在该内积下, 任意函数 满足再生性质: .
为了达到这一目标, 整体思路为:
- 首先定义 PSD 核函数 和对应的核截断 .
- 利用核截断构造一个函数线性空间 .
- 在该函数空间上定义由 kernel 诱导的内积.
- 用这个内积直接推出 reproducing property.
- 最后对该空间进行完备化, 得到 RKHS.
更详细的 RKHS 定义和构造见 RKHS and Representer Theorem.