References
1. Introduction
1.1 Preliminary: Fenchel Conjugate
给定 是一个 proper, closed, convex 函数, 其 subgradient 在 处定义为:
其有性质如下.
Property 1. 当且仅当 .
Proof
由 可得对任意 , 有 , 从而 , 即 .
的 Fenchel conjugate 定义为:
其有如下性质.
Property 2. 当且仅当 .
Proof
由 可得 , 即 . 根据 Fenchel conjugate 的定义, 可得 . 而对任意 , . 从而将两式相减, 有 , 即 .
Property 3. 若 是 closed, proper, convex 函数, 则 是 -strongly convex 是 -Lipschitz 的.
Proof
记 , . 由于 是 -强凸的, 故 也是 -强凸且唯一最小值取在 的函数 (由强凸可推出 可微, 故后文取 合法). 根据强凸的性质, 对于任意 有:
再令 , 则有:
同理, 对称地以 为最优点、代入 可以得到
从而将两式相加, 化简整理有
再根据 Cauchy-Schwarz 不等式, 有:
最后根据 Fenchel conjugate 的性质 1,2, 有 , . 故命题成立.
由于 是 -Lipschitz smooth, 故对任意参考点 , 同样也是 -Lipschitz smooth 的. 因此, 对于任意 , 有:
由上式 pointwise 成立, 故对左右两侧同时求关于 的最小值, 有
其最优值就是通过直接求导可得. 以及根据 Fenchel conjugate 的定义, 以及性质 , 有:
故我们能得到不等关系:
进一步, 取参考点 , 则根据 conjugate 的两个事实: (a) ; (b) Fenchel-Young Inequality: (该不等式在 时取等). 因此将上述两个事实代入不等关系中, 即有:
即 是 -strongly convex
1.2 Dual First-Order Methods
Intuition.
考虑等式约束凸优化问题:
其中 是一个凸函数, 是一个矩阵, 是一个向量.
- 考虑其 Lagrangian 函数: 其中 是 对偶变量.
- 对应的对偶函数为:
Gradient Information of Dual Function.
对于这类性质良好的凸优化问题 (凸且约束为 affine), 则只要约束本身是可行的, strong duality 就会自动满足. 因此求解原问题的最优解, 等价于求解对偶问题 的最优解. 故很自然地考虑用梯度法等一系列一阶方法来求解对偶问题. 不过由于 本身是通过 inf 定义的, 因此需要更仔细分析其具体性质.
的 Fenchel conjugate 定义为:
- 因此, 可以根据 Fenchel conjugate 的定义, 将对偶函数 表示为:
- 若定义 , 则根据 Preliminary 中的两条性质, 立即有 (注意这里的 subgradient 是针对 的 input 整体的). 若进一步表示成关于 的 subgradient, 则有 , 或等价地, . 又知 . 因此, 将两个 subgradient 相加, 即可得到最终结论:
- 该式给我们的启发是: 对于 dual gradient 的计算, 不需要显式进行求导, 而只需要求解由给定 所决定的 primal problem 的最优解.
Dual Gradient Ascent.
上式给我们提供了关于对偶函数的梯度信息. 因此全部的一阶方法都可以以此为基础进行设计. 例如最基本的 Dual Gradient Ascent 方法. 假设 是 strictly convex 的. 则 (1) 具有唯一解; (2) dual function 是可微的, 即 . 故可以总结 Dual Gradient Ascent 方法. 初始化一个对偶变量 后, 则可以依次开始对 进行迭代:
其中 是 step size, 可以通过正常的 line search 等方法进行选择.
- 第一步 primal update, 就是最小化在当前迭代下原问题 的 Lagrangian (只相差了一个与优化变量 无关的常数项 ). 通过该步, 就得到了当前迭代下的 dual function. 并且证明出, 最优点 对应的 就是当前迭代下 dual function 的梯度.
- 第二步 dual update, 就是根据第一步得到的梯度信息, 对 dual function 进行梯度上升, 使得 dual function 的值不断增加, 从而逐渐逼近其最优值.
在 strong duality 被满足的条件下, 当求得 时, 由此诱导的
将自动成为原问题的最优解.
Convergence Analysis.
Dual gradient method 只是 gradient method 应用在对偶问题上的一个特例. 因此其收敛性符合 gradient method 的正常分析. 例如,
- 若优化目标 是凸且 -smooth 的, 则当 step size 选择为 时, 有 sublinear 的收敛率 , 是目标精度.
- 若目标是 -strongly convex 且 -smooth 的, 则 GD 方法是 linear convergence 的, 即当 step size 选择为 时, 有 的收敛率.
因此, 根据上述原函数与 conjugate 的关系, 可以得到如下结论:
- 若 是 -strongly convex 的, 则 是 -smooth 的, 因此该 dual ascent 是 sublinear 收敛的, 并且最优步长 .
- 若 是 -strongly convex 且 -smooth 的, 则 是 -smooth 且 -strongly convex 的 (相当于同时将定理反过来用了一次), 因此该 dual ascent 是 linear 收敛的, 并且最优步长 .
不过更严谨地讲, 这里我们的目标函数事实上为 , 因此需要进一步考虑 的影响. 根据算子范数的定义, 可以得到
其中 是 的最大奇异值. 因此各步长等还需要根据具体矩阵的条件数进行调整.
2. Dual Decomposition
2.1 Distributed Optimization via Dual Decomposition
Dual Decomposition for Equality Constraints.
上述的 Dual Gradient Ascent 方法还只是关于对偶的一个最基本的应用. 其更为核心的应用是将一个复杂问题进行分解, 从而实现并行分布式优化.
考虑如下 目标可分, 约束耦合 的优化问题:
其中 是一个 block vector, 其中每一个 block 是一个子向量, , 并且每个 仅依赖于 . 然而其约束却是耦合的, 即 中 是一个 的矩阵, 其每一行都可能同时依赖于多个 block .
因此我们可以 accordingly 地对 进行 block partition, 即 , 其中 是一个 的矩阵. 从而可以将原问题表示为:
对该优化问题套用前面的 dual gradient ascent 方法, 则在每一次迭代中, 其 primal update 的步骤为:
而这里, 观察到其中的每一项 仅依赖于 , 因此这 项独立解耦的最优化问题就可以被独立各自分开求解, 从而实现并行分布式优化. 这就是 Dual Decomposition 的核心思想. 故其 primal update 的步骤可以被改写为:
Dual Decomposition for Inequality Constraints (Projected Subgradient Approach).
若进一步将上述等式约束改为不等式约束, 即
则整个的 Dual Ascent 方法的框架仍然是一样的, 只是需要在每一次迭代中, 对更新后的 进行一个 projection, 即
其中 是一个逐元素的 projection operator, 将输入的每一个元素都投影到非负实数上.
- 从算法角度看, 该方法是 projected subgradient method 的一个特例. 在每一次迭代中, 必须要保证对应的 Lagrangian multiplier 是非负的, 因此需要在每一次迭代中进行 projection.
Distribution Optimization.
这是一个 synchronous 的分布式优化算法. 其每一次迭代中, 每一个 block 都可以分发 (broadcast) 到不同的计算节点上独立求解, 从而实现并行化. 然而在进行梯度迭代时, 需要将所有 block 的结果进行聚合 (gather), 等到收集齐全的 block 结果后才能进行下一步的迭代.
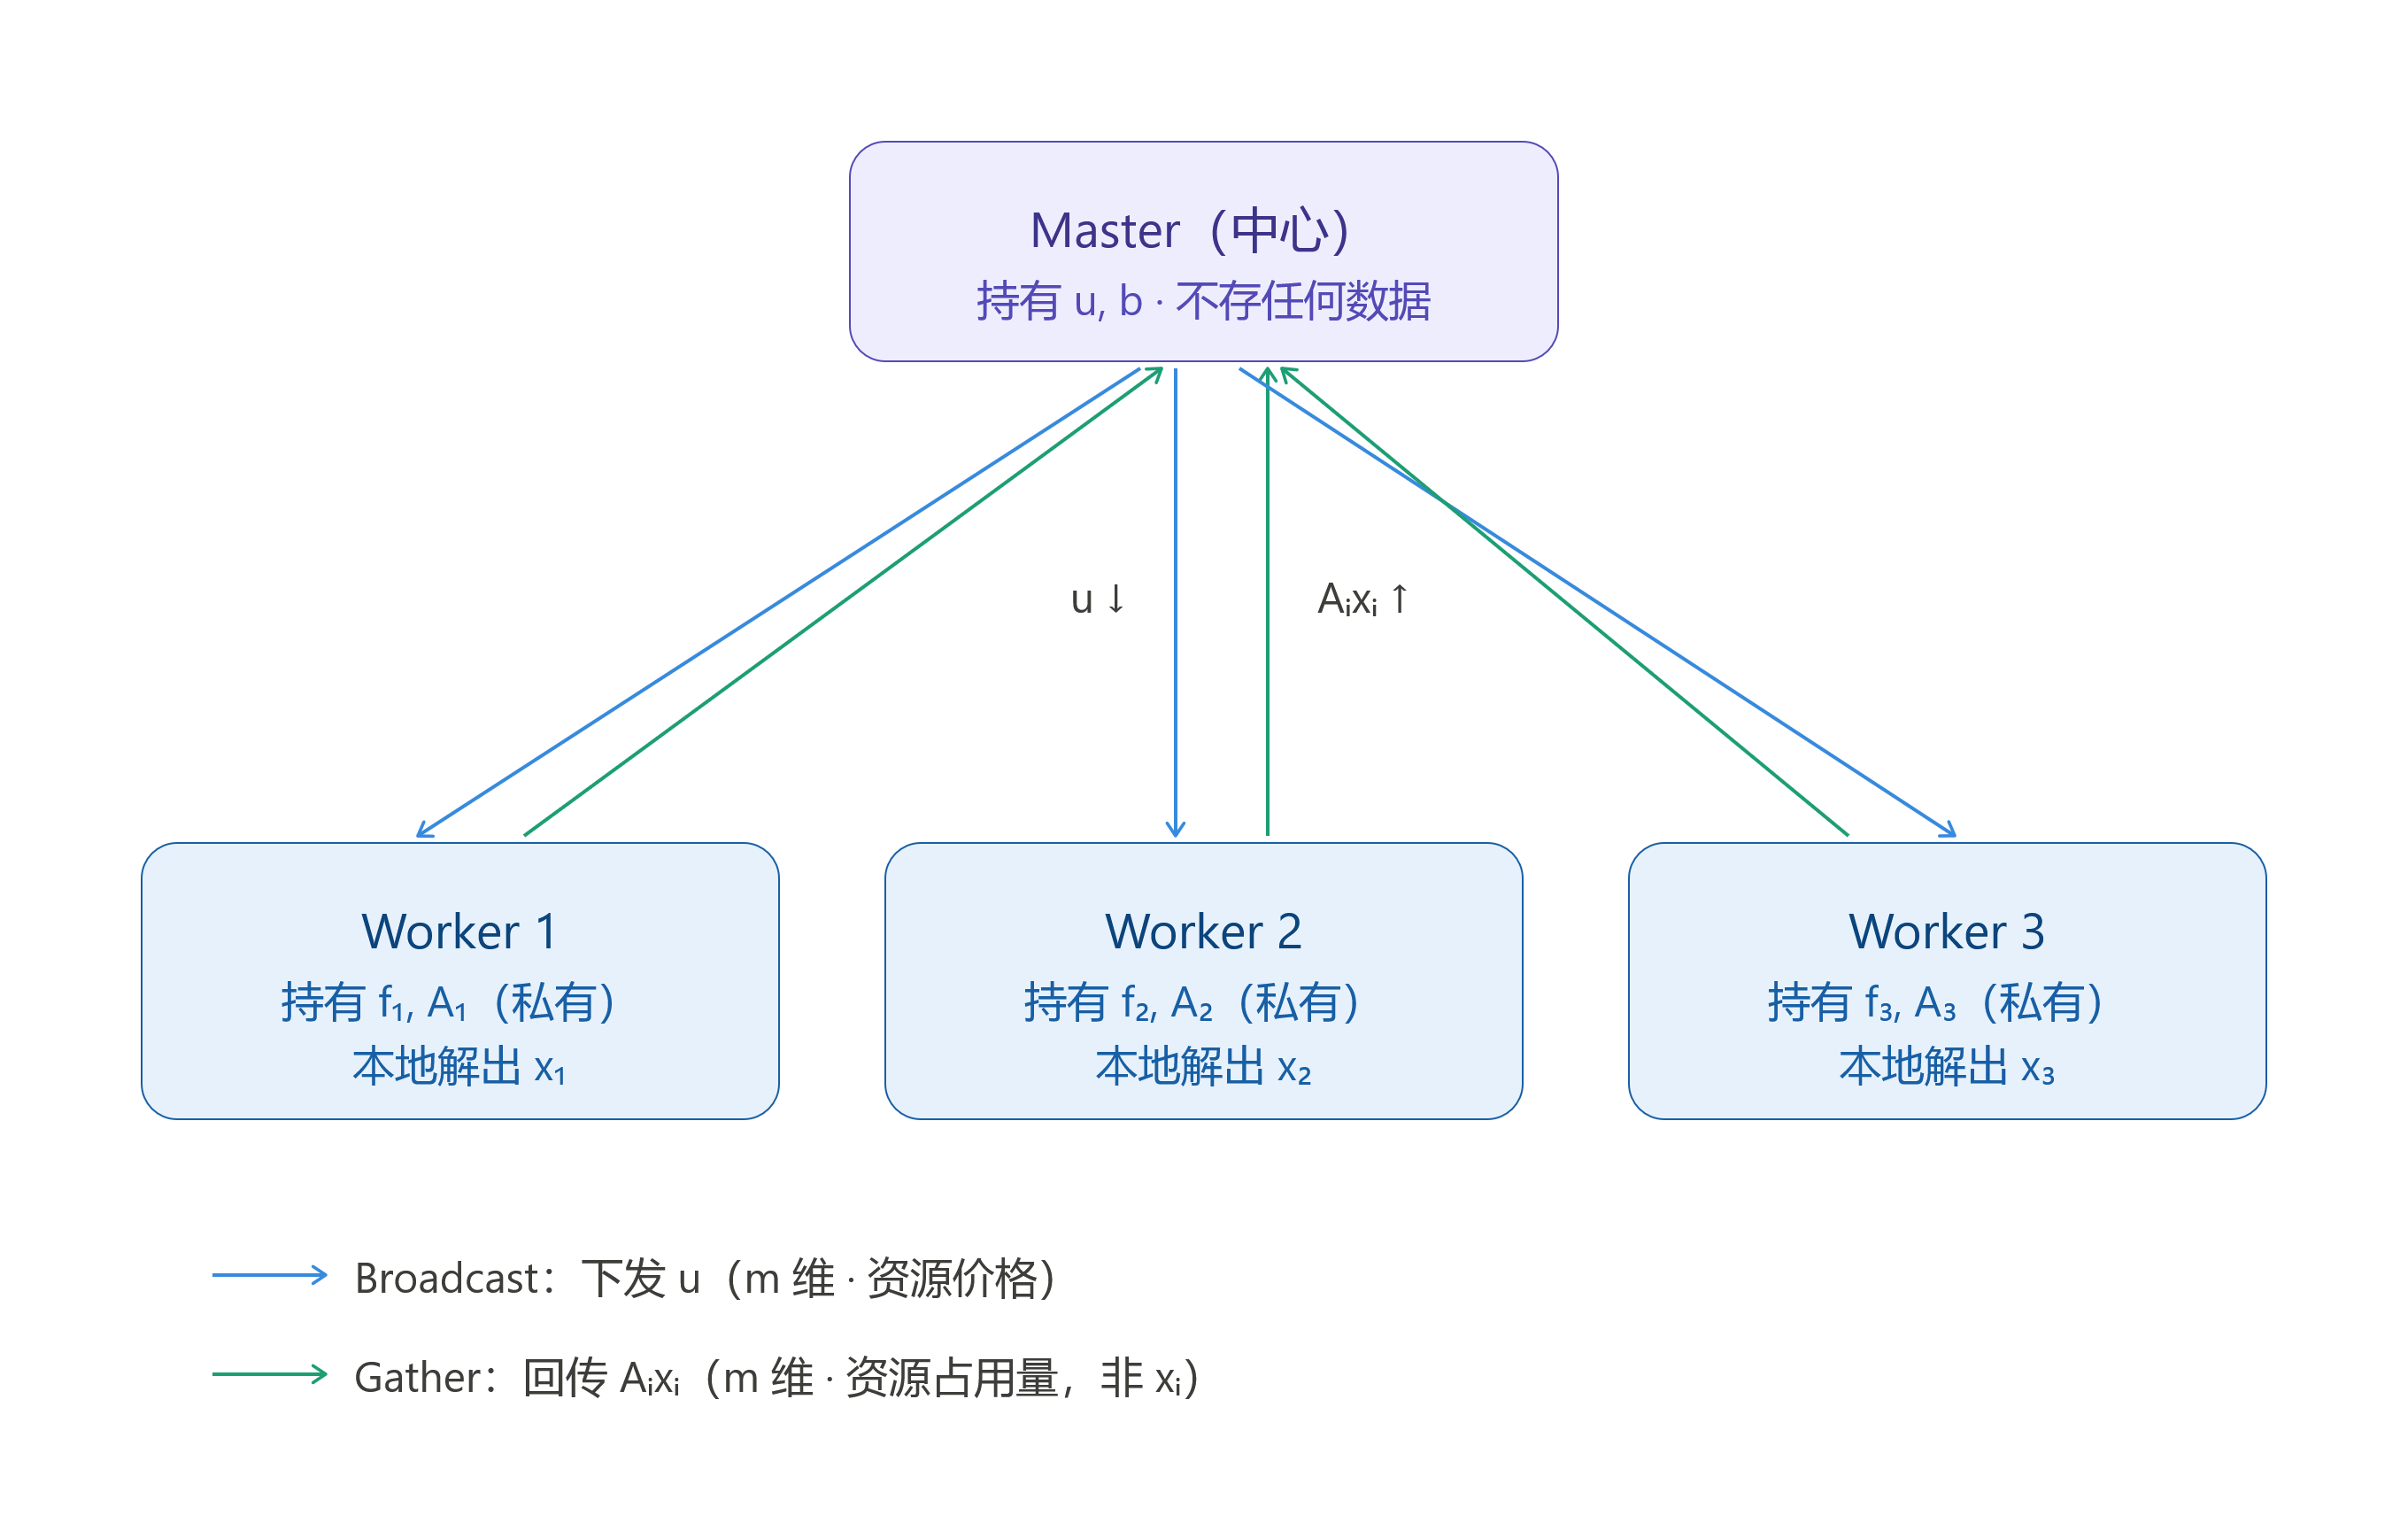
借此场景进一步讨论一下这种 synchronous 的分布式优化算法.
- 在许多现实场景中, 事实上并不是数据被分发到不同的计算节点上, 而是数据本身就天然地分布在不同的计算节点上. 例如以现实场景为例. 一共有 个单位, 每个单位 都有自己的本地数据, 这些数据或因隐私政策, 或因数据规模等种种原因, 无法进行集中式的存储和处理. 然而与此同时, 整个系统又想在共享约束 (由于总资源 的分配等原因, 导致约束耦合) 的条件下, 对各自 local objective 的加总进行优化, 其中 是第 个单位的本地决策变量. 这时, Dual Decomposition 就提供了一个非常自然的解决方案.
- 这里梳理整个优化系统的各方角色.
- Master (中心): 持有对偶变量 , 以及全局的约束 . 其不持有任何具体的 block 或 local objective . 其主要负责在每一次迭代中, 将当前的对偶变量 分发给各个 worker, 等待收集齐全的 block 结果后, 对 进行梯度更新. 其中 是每一个 worker 计算得到的 block 结果, 需要被 master 收集后才能进行下一步的迭代. 并且对于 master 来说这是一个 维的黑盒结果, 其并不知道具体的 或 的任何信息.
- Worker (计算节点): 每一个 worker 持有一个 block 和 local objective . 其主要负责在每一次迭代中, 根据 master 分发的对偶变量 , 以及本地的 block 和 local objective , 来求解该 block 的最优化问题, 从而得到 block 结果 , 并将该结果上传给 master.
因此可以汇总该种方法的特性.
- 劣势:
- Straggler effect. 由于每一个 block 的计算时间可能不一样, 因此在每一次迭代中, 若有节点的子问题特别困难或通信等出现问题, 那么其余的 worker 即使已经完成了计算, 也只能等着该节点完成后才能进行下一步的迭代. 因此 straggler effect 就会导致整体的效率降低.
- 优势:
- 通信量小. 每轮每个 worker 只需要传输 和 两个 (即约束维度) 维的向量, 其往往远小于 block 的维度 . 因此通信量较小, 适合于通信受限的分布式系统.
- 隐私保护. 每个 worker 只需要将 这样的 block 结果上传给 master, 而不需要上传具体的 或 local objective 的任何信息. 节点之间同样也不需要直接进行通信. 因此该方法适合于隐私受限的分布式系统.
- 可扩展. 中心的计算复杂度不会因节点数的增加而增加.
Price Coordination Interpretation (Vandenberghe).
此外, 进一步沿用当前的现实例子进一步加深对于对偶问题的理解.
-
对于每个单位 , 其可以自行决定自己的 local decision , 从而得到 local cost . 但是由于整个系统的资源是有限的, 因此每个单位的决策都必须满足一个全局的约束 . 其中 中的每一行就代表了一个资源的总量 (例如电力, 总带宽, 总预算等).
-
对应的对偶变量 , 其就相当于每一项资源的单位价格. 回顾每个 worker 解决的子问题
其第二项 就相当于每个单位 需要为自己使用的各项资源的用量 , 以单价 进行支付的成本. 因此, 每个单位 在做决策时, 不仅要考虑自己的 local cost , 还要考虑自己使用的资源所带来的成本 .
-
而 master 的更新步骤
可以理解为一个价格调整的过程. 定义 slack variable , 其中 中的每一项 就代表了第 个资源的剩余量. 当 , 就说明该项资源已经被过度使用了, 因此 master 会以 的幅度增加该资源的价格 , 从而在下一轮迭代中, 促使各个单位减少对该资源的使用. 反之亦然. 此外, 整个系统还会加上一个价格触底的保护机制, 即 不会被调整到负数 (倒贴钱), 从而保证了价格的合理性.
3. Augmented Lagrangian Method (ALM) / Method of Multipliers
ALM 是一类解决有约束问题的经典方法. 其既可以是在 Dual Ascent 的视角出发, 视作是其对 primal 的一种 regularization; 可以看作是对 penalty method 的一种改进, 通过引入对偶变量来避免 penalty method 中的数值不稳定问题. ALM 的细致分析将单独进行展开, 这里现只单纯在 dual decomposition 的基础上, 介绍一下 ALM 的基本思想.
3.1 Intuition of ALM
回忆在前面的 Dual Ascent 中, 若对偶目标函数期望达到线性收敛, 则需要对偶目标函数光滑且强凸, 这对应着原函数需要同时满足强凸和光滑. 因此, 一种理解 ALM 的 motivation 的思路就是, 通过在 primal problem 中引入一个 quadratic penalty term 来增强原函数的强凸性, 从而放松对于原函数 的要求.
对于原始问题
其对应的 ALM 的 primal 为:
其中 是一个 penalty parameter.
可以看到, 这两个问题在可行域上是完全等价的. 然而通过额外引入的二次项, 使得 ALM 的 primal objective function 具有更好的性质.
- 例如, 考虑其 Hessian: 其中 只要 是 full column rank 的. 这也就使得 primal objective function 不论原函数 的性质如何, 都具有强凸性.
3.2 ALM as Dual Ascent of Augmented Primal Problem
故对 Augmented primal problem 进行 dual decomposition, 则其 primal update 的步骤为:
注意到, 这里的步长 已经被固定为 . 下将证明, 这样的选择会恰好让每次的 dual 迭代点满足原始问题的 Stationarity 最优条件:
- 由于 是 primal update 的最优点, 则其满足该问题的 KKT 条件, 即
- 由上式可见, 每一次迭代的 dual variable 只要按照步长 进行更新, 就能保证 primal variable 满足原始问题的 stationarity 条件.
同时另一方面, dual update 也起到了对于 primal variable 的 feasibility 的促进作用. 当且仅当 primal variable 满足可行性条件 时, dual variable 才会保持不变.
总的而言, 考虑原始问题 的 KKT 条件:
- Stationary: 这在 ALM 中每一个 primal update 的步骤中都被满足了.
- Feasibility: 这在 ALM 中通过 dual update 中 asymptotically 满足.
因此通过 ALM 的 primal update 和 dual update 的交替迭代, 就能同时满足原始问题的 stationarity 和 feasibility 条件, 从而最终收敛到原始问题的最优解. 进而, 只要 满足一些 mild conditions 等, 就可以满足 strong duality, 从而保证 ALM 的收敛性. 这相比于 Dual Ascent 来说, 其对于原函数 的要求被大大放宽.
然而, ALM 的 primal update 中引入了一个 quadratic penalty term, 考虑前述的分块结构, 可以观察到
而这里由于 这一项的存在, 导致不同 block 之间的耦合, 从而无法进行分解. 因此 ALM 的代价是破坏了 decomposability, 从而无法进行分布式优化. 这也为后文的 ADMM 的设计提供了一个重要的启发.
4. Alternating Direction Method of Multipliers (ADMM)
ADMM 同样也是在有约束优化领域的重要经典方法. 其主体内容也将详细地进行展开分析. 这里同样也只是站在上面提到的 ALM 的基础上, 尝试通过进一步的改进, 整合 ALM 和 Dual Decomposition 的优势.
4.1 Intuition of ADMM
考虑一个两块分块的优化问题:
这样的问题在很多现实场景中都非常常见, 例如:
- 在 Lasso regression 等中, 是损失函数, 是正则项, 约束 .
- 在复合优化中, 是 smooth function, non-smooth 但 proximal-friendly.
- 在分布式优化中, 是 local objective, 是 global objective, 约束 则是耦合约束.
沿用前面 ALM 的思路, 对其进行 Augmentation:
这个优化问题对应的 Lagrangian function 为:
回顾, 若沿用 ALM 的 primal update 的步骤, 则需要同时对 和 进行联合优化, 即
然而同样地, 由于 这一项的存在, 导致 和 之间的耦合, 从而无法进行分解.
因此 ADMM 的核心思想就是, 不再联合求解 primal Lagrangian 的最小值, 而是通过 alternating optimization 的方式, 交替地对 和 进行优化. 具体而言, ADMM 的 primal update 的步骤为:
然后再进行 dual update:
注意, 这里的 decomposition 是通过交替更新实现的, 应当区分其与 Dual Decomposition 中的 parallel decomposition.
因此, ADMM 对于一般的温和条件
- 不要求 是 full column rank
- 不要求 是强凸或可微的
- 只需要是正常凸, 约束有可行解等即可
都能保证收敛到原始问题的最优解, 并且同时和步长 无关, 其只会影响收敛的速度但不会影响收敛的结果. 并且一般有如下收敛保证:
- Feasibility Convergence: .
- Objective Convergence: .
- 注意, 这里只保证了 objective value 的收敛, 并不保证 primal variable 的收敛. 例如, 在某些 degenerate 的问题中, 可能存在多个 primal optimal solution, 从而导致 primal variable 的震荡, 但其 objective value 却是收敛的.
- Dual Convergence: .
4.2 Scaled Form of ADMM
Scaled Form ADMM 和 ADMM 在本质上完全等价. 其事实上就是在对 进行适当的变量替换进行配方, 以得到一个更为简洁的形式.
通常引入 scaled dual variable . 则 Lagrangian 可以写为:
因此 ADMM 的更新公式可以用 scaled dual variable 来表示, 从而得到更为简洁的形式:
不过确实在进行缩放之后, 起到了 running sum of residuals 的作用, 用来记录历史上所有约束违反的总和.
4.3 Examples
4.3.1 Alternating Projections
Alternating Projections 是一种经典的 ADMM 应用场景.
给定两个凸集 , 优化的目标是寻找两个凸集的交集中的点. 若引入 indicator function:
则可以将寻找交集中的点的问题转化为如下优化问题:
尝试使用 ADMM 解决该问题. 对应标准形式, 则有
其中 .
代入 ADMM 的更新公式, 则有
观察这里的更新公式, 可以发现
而后者恰恰是将点 投影到集合 上的数学定义. 对于 同理. 因此我们的更新公式可以写作:
综上, 这样的 ADMM 其实就相当于交替进行集合 和集合 上的投影, 而投影对许多集合都有简单的闭式解, 因此极大地简化了求解过程.
若再对比对于该问题的经典 von Neumann 算法, 则其迭代公式为
其唯一的区别在于 ADMM 引入了一个 dual variable 作为当前位置的 offset, 这体现了通过历史偏差的累积这一信息, 对当前投影进行了修正.
4.3.2 Group Lasso
给定 , 以及 , 其中 被分为 个子向量 (groups), 记为 , 其中 且 . Group Lasso 的优化问题可以写为:
直接对该问题进行求解可能会比较困难, 因为平方损失和不光滑的组范数正则化项混合在一起. 但是我们可以通过引入一个新的变量 来将问题分解为两个部分:
代入 ADMM 的迭代更新公式, 我们可以得到:
-
-update:
这是 ridge regression 的闭式解.
-
-update:
其中
是 -norm 的 soft-thresholding proximal operator. 其作用是, 如果输入向量 的模长小于阈值 , 则整组被置为零, 否则将其模长收缩 .
-
-update:
说明:
- 在具体计算时, 可以对 进行一次 Cholesky 分解, 然后在每次迭代中使用该分解来高效地求解 -update.
- 只要某个范数的 prox 乘子是给定的, 都可以高效地进行推广计算.
4.3.3 Sparse + Low-Rank Matrix Decomposition
给定矩阵 (如视频中每一帧拉直后堆叠成的矩阵), 我们希望将其分解为一个稀疏矩阵 和一个低秩矩阵 的和:
- 是矩阵的 trace norm, 也称为 nuclear norm, 是矩阵奇异值的和, 用于鼓励低秩解. 在数据中, 对应相对稳定, 低维的背景或主结构部分.
- 是矩阵的 entry-wise norm, 用于鼓励稀疏解, 用来吸收局部突出的异常或前景部分.
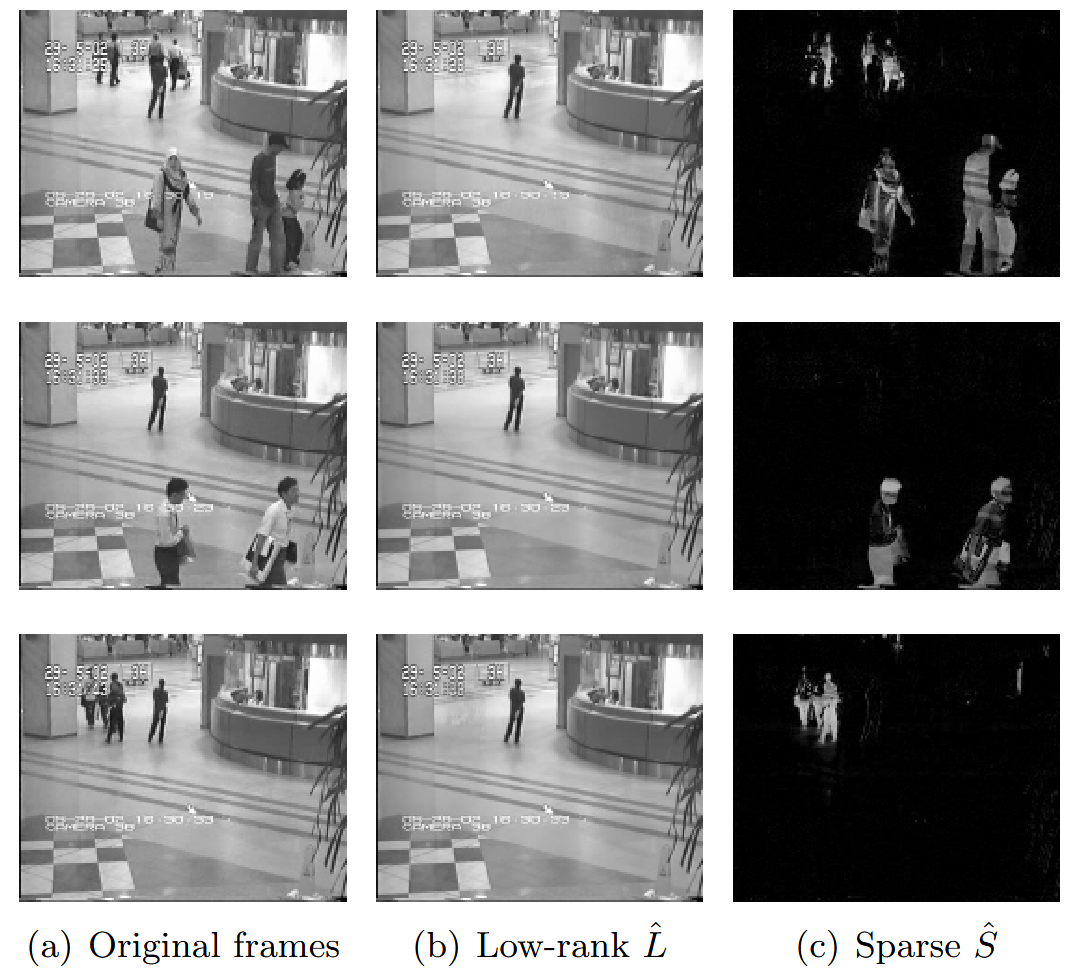
同样可以使用 ADMM 来求解该问题, 迭代过程如下:
其中 是 trace norm 的 proximal operator, 其先对矩阵进行 SVD 分解, 然后对奇异值进行 soft-thresholding, 最后再重构矩阵.
4.4 Discussion
这里限定为无约束的 ADMM 问题:
即标准形式中对应 .
回顾, proximal operator 的定义为:
因此, 若对照 scaled ADMM 的更新公式, 取 , 则可以看出 ADMM 的更新步骤可以看作是对 和 的 proximal operator 的调用, 然后再对结果进行修正.
在实践当中, ADMM 有时会遇到如下问题.
- ADMM 通常会快速收敛到一个还不错的解, 但是在追求高精度时会变慢;
- ADMM 的收敛速度对 的选择非常敏感, 需要进行调参;
- 对同一个原问题采用不同的分解方式, 会得到不同的 ADMM 算法, 其收敛速度也会不同.
4.5 Consensus ADMM
前面的 dual decomposition 中曾经实现过分布式优化, 但在 vanilla 的 ADMM 中, 由于 和 的耦合, 使得其无法直接进行分布式优化. Consensus ADMM 是 ADMM 的一个重要变体, 其主要用于解决分布式优化问题.
假设共有 个 worker, 每个 worker 有自己的 local data 以及对应的损失 , 但所有 worker 都共享一组 global variable . 其优化问题可以写为:
Consensus ADMM 的核心思想是, 给每个 引入一个 local copy , 然后强制所有的 local copy 都等于 global variable 以 “达成共识(consensus)“. 于是问题可以改写为:
通过这种分解, 全局原本耦合的问题被拆分为 个局部问题, 每个 worker 只需要处理自己的 local copy , 并且通过与 global variable 的交互来达成共识. 这恰好变成了 ADMM 可以处理的标准形式问题:
进一步, 观察到 , 因此 可以被省略, 从而简化了 的更新公式:
因此, 这里各个 worker 的 -update 可以并行进行, 而 -update 则是一个简单的平均操作, 这使得 Consensus ADMM 非常适合分布式计算环境.
若考虑更一般的 Consensus ADMM, 其优化问题可以写为:
- 每个 worker 独立地在自己的数据 上计算 local loss , 而 则是对全局变量 的约束或正则化.
同样引入 global copies, reparametrize:
- 注意到, 这里的正则项是没有进行分解的, 其需要汇总到中心节点进行处理.
则应用 ADMM, 其更新公式为:
4.6 Special Decomposition
需要说明, 不同的 reparametrization 会导致不同的 ADMM, 不同的方式会极大地影响收敛速度. 这里给出粗略的讨论. ADMM 在形式上和 block coordinate descent 非常类似, 其每次迭代只更新一部分变量, 而其他变量保持不变. 因此, 在设计 ADMM 的拆分形式引入辅助变量时, 应当尽量保证不同块之间彼此正交, 从而减少耦合震荡, 以加快收敛速度.