References
- Reading: 邱怡轩, 2023 深度学习讲义
- Reading: Dive into Deep Learning (D2L)
- Reading: 邱锡鹏, 《神经网络与深度学习》
- Lecture: 李宏毅, Deep Learning
1. 人工神经元
Feed-forward Neural Network (前馈神经网络, FNN) 是一种最简单的神经网络, 其属于 Artificial Neural Network (人工神经网络, ANN) 的一种. ANN 是一种受到生物神经网络启发的数学模型. 神经网络最早是连接主义的典型代表, 其主流的特点包括:
- 其基本的构成单元是人工神经元 (Artificial Neuron);
- 信息是分布式存储, 而非局部集中的;
- “记忆和知识”存储在不同神经元之间连接的权重上;
- 通过逐渐改变神经元之间的连接权重来学习新的知识;
- 神经元负责信号(即数据)的输入和输出
现代的人工神经元结构基本源自 Rosenblatt 的感知机 (Perceptron):

An image of the perceptron from Rosenblatt’s “The Design of an Intelligent Automaton,” Summer 1958.
一个典型的现代人工神经元如下图所示:
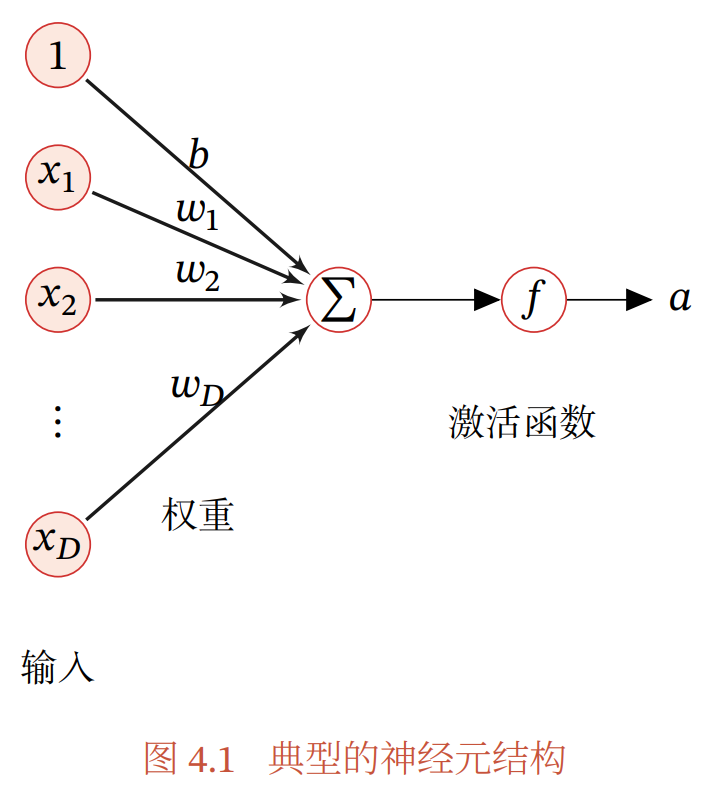
其基本的流程包括: 输入信号 加权求和 激活输出. 其中, 输入信号是输入数据的特征, 加权求和是对输入信号进行线性组合, 激活输出是对线性组合的结果进行非线性变换. 上图所示的人工神经元的数学表达式如下:
其中, 是输入信号, 是权重, 二者可分别向量化记为 和 , 是偏置, 是激活函数, 是加权求和的结果, 是激活输出.
其表现形式基本上相当于一个线性模型+非线性激活函数, 其中线性模型负责对输入信号进行线性组合, 而非线性激活函数则负责对线性组合的结果进行非线性变换.
2. 激活函数
Rosenblatt 的感知机中使用的激活函数是阶跃函数, 例如:
不过当今为了增强神经网络的表达能力, 激活函数一般需要满足以下性质:
- 非线性: 使得神经网络可以拟合非线性函数;
- 连续可导: 除了少数点外处处可导;
- 计算简单, 数值稳定: 使得神经网络的训练更加高效稳定.
关于激活函数的讨论很多, 这里简单介绍几种常见的激活函数.
2.1 Sigmoid (S-) 型 激活函数
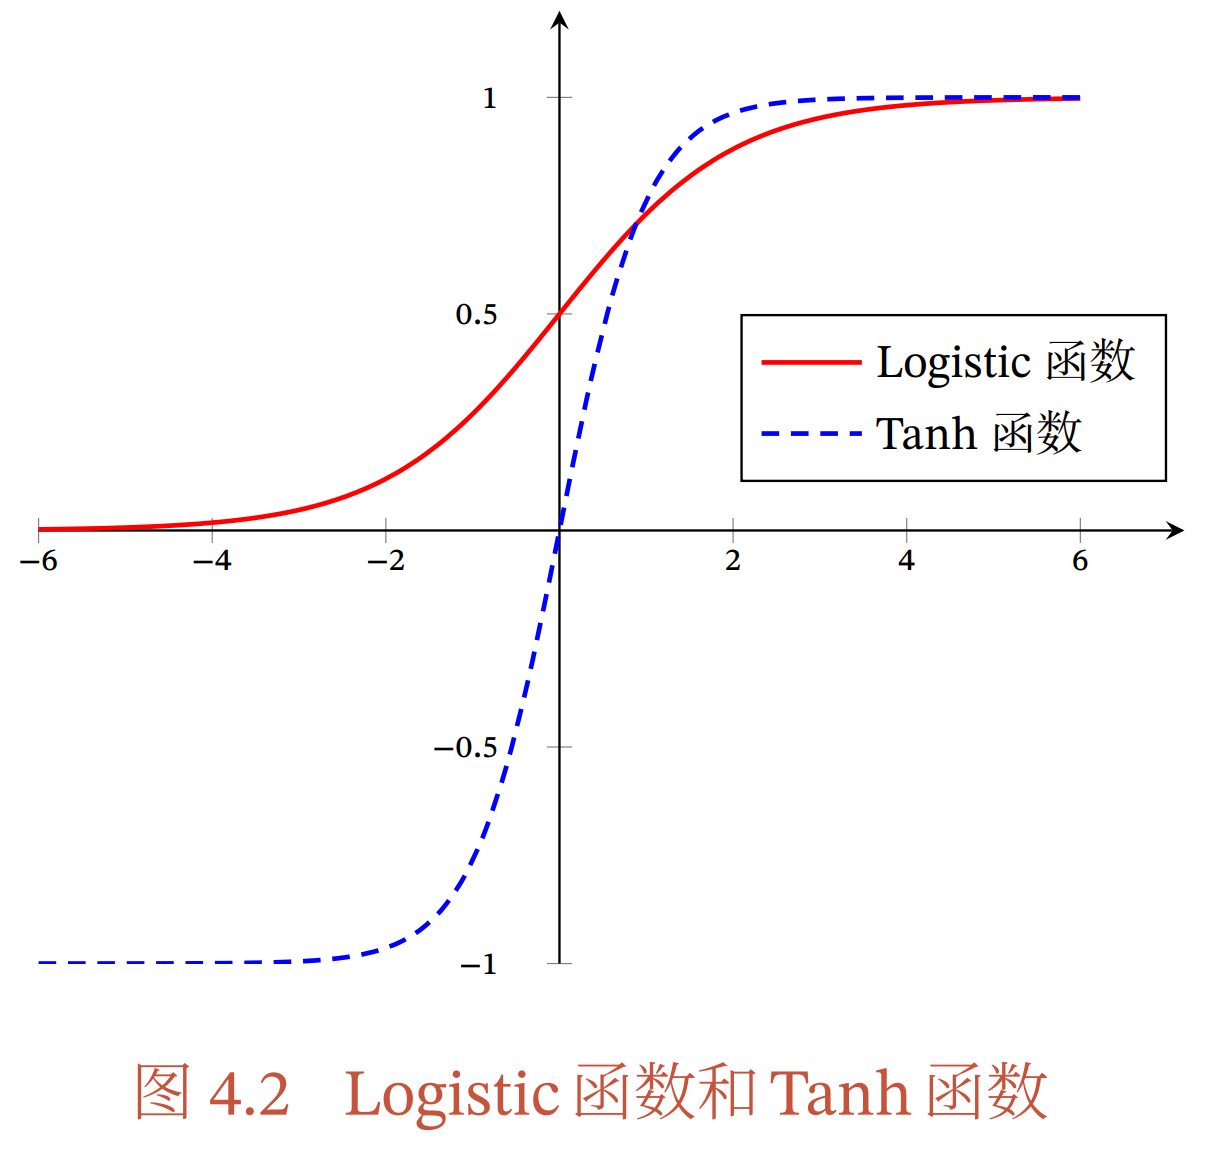
2.1.1 Sigmoid / Logistic 函数
其表达式为:
Sigmoid 函数可以认为将 上的值映射 (“挤压”) 到 上. 其优点是 1) 输出值在 之间, 可以看作概率值, 适合用于二分类问题. 2) 可以看作是一个 Soft Gate, 用来控制神经元输出信息的数量.
2.1.2 Tanh 函数
其表达式为:
Tanh 函数可以认为是 Sigmoid 函数 的变形:
Tanh 函数可以认为将 上的值映射到 上, 是以 为中心的. 相对而言, 由于 sigmoid 函数是恒大于 的, 这样的输出会导致 Bias Shift (偏置移位) 问题, 使得神经网络的训练变得困难 (后面会指出使得梯度下降的收敛速度变慢).
2.1.3 Hard-Sigmoid & Hard-Tanh 函数
Sigmoid 函数和 Tanh 函数在实际应用中的计算开销较大, 为了提高计算效率, 有时会使用 Hard-Sigmoid 和 Hard-Tanh 函数. 其相当于用分段的线性函数来近似 Sigmoid 和 Tanh 函数. 而线性函数的计算开销较小, 从而提高了计算效率.
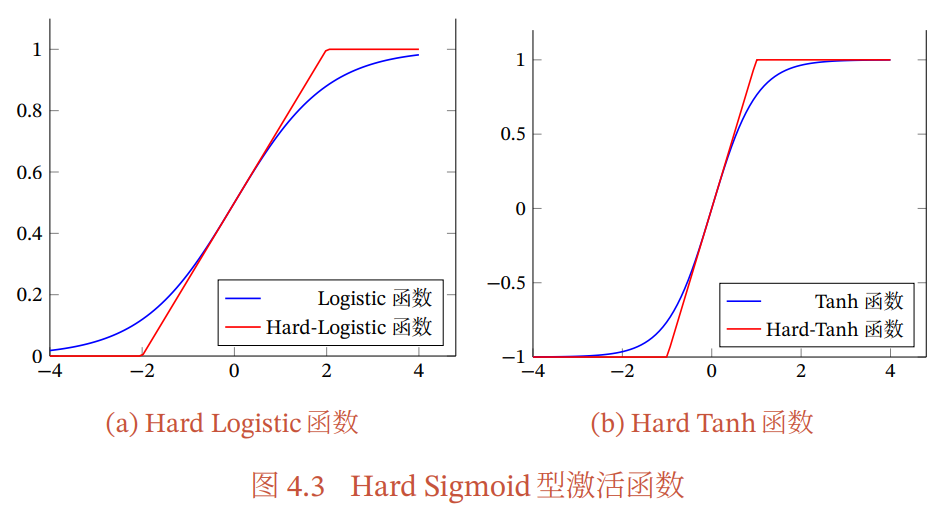
通过在零附近进行泰勒展开并整理分段函数为 之形式, 可以得到的 Hard-Sigmoid 和 Hard-Tanh 函数如下:
2.2 ReLU (Rectified Linear Unit) 激活函数
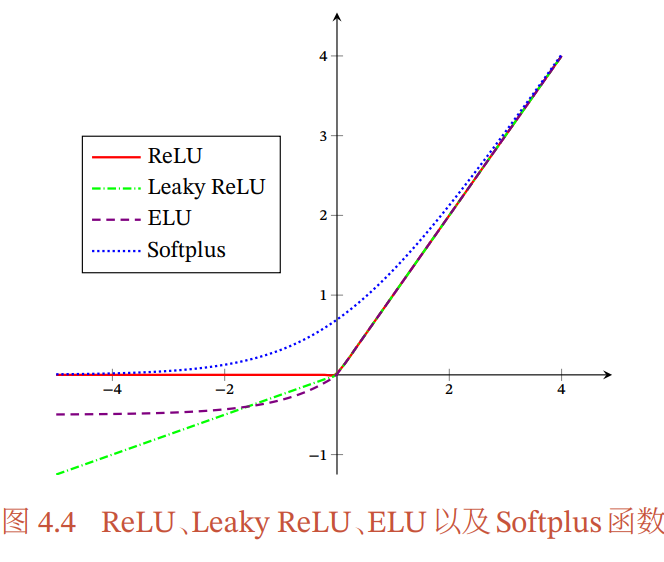
ReLU 函数是目前最常用的激活函数之一, 其表达式为:
ReLU 函数的优点是 1) 计算简单, 只需要比较大小; 2) 符合生物学直觉, ReLU 会生成一个稀疏的神经网络, 与人脑的神经元激活方式更加接近; 3) 一定程度上缓解了梯度消失问题 (后面会详细讨论), 使得神经网络的训练更加稳定.
ReLU 的缺点之一是会导致 Dead Neurons (神经元死亡) 问题, 即当输入值小于 时, ReLU 的梯度为 , 如果参数在某次不恰当的参数更新后, 某个神经元自身的梯度可能会一直为 , 不再更新.
经验上, 不知道如何选择时, 不妨使用 ReLU 函数作为默认选项.
因此有时也会使用 ReLU 的一些变种:
2.2.1 Leaky ReLU
Leaky ReLU 将 ReLU 函数的负半部分调整为一个小的斜率 :
其中 是一个小的常数, 例如 .
2.2.2 PReLU (Parametric ReLU)
与 Leaky ReLU 类似, PReLU 是一个参数化的 ReLU 函数, 不过其负半部分的斜率是一个可学习的参数:
2.2.3 ELU (Exponential Linear Unit)
ELU 函数是另一种 ReLU 的变种, 其表达式为:
其中 是一个需要提前人为设定的超参数.
2.2.4 Softplus 函数
Softplus 表达式为:
3. XOR 问题与前馈神经网络
3.1 XOR 问题: 单层感知机的局限性
对于前文给出的单层感知机:
这里考虑一个最简单的版本: 二维输入 () 且 , 二分类输出 (), 且激活函数为阶跃函数. 如下图所示:
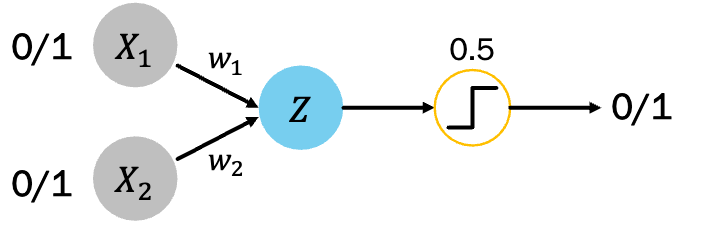
甚至不需要机器参与, 我们可以通过简单的逻辑推理来找到 的参数取值, 得到 AND 和 OR 问题的解决方案. 具体而言, 我们希望 INPUT 和 OUTPUT 之间的关系分别为:
| INPUT () | INPUT () | OUTPUT ( AND ) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
我们可以求得 AND 问题的解决方案为:
| INPUT () | INPUT () | OUTPUT ( OR ) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 1 |
我们可以求得 OR 问题的解决方案为:
但是对于 XOR 问题, 我们无法找到一个合适的参数取值使得单层感知机可以解决 XOR 问题. 具体而言, XOR 问题的输入输出关系如下:
| INPUT () | INPUT () | OUTPUT ( XOR ) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
这启示着:
- 单层感知机有很大的局限性, 无法解决即使是简单的 XOR 问题;
- 我们或许可以将多层的神经元串联起来, 构建多层的神经网络, 以解决更复杂的问题.
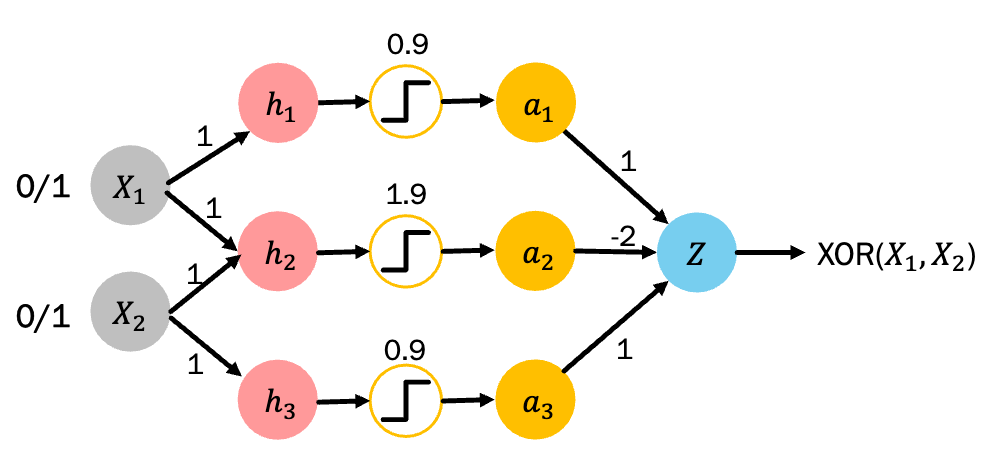
事实上, 只需要增加一层神经元, 就可以解决 XOR 问题:
3.2 多层感知机 (MLP) / 前馈神经网络 (FNN)
根据上面的启示, 我们可以将多个神经元串联起来, 构建多层的神经网络, 以解决更复杂的问题. 这样的神经网络被称为多层感知机 (MLP) 或者前馈神经网络 (FNN). 一个典型的前馈神经网络如下图所示:
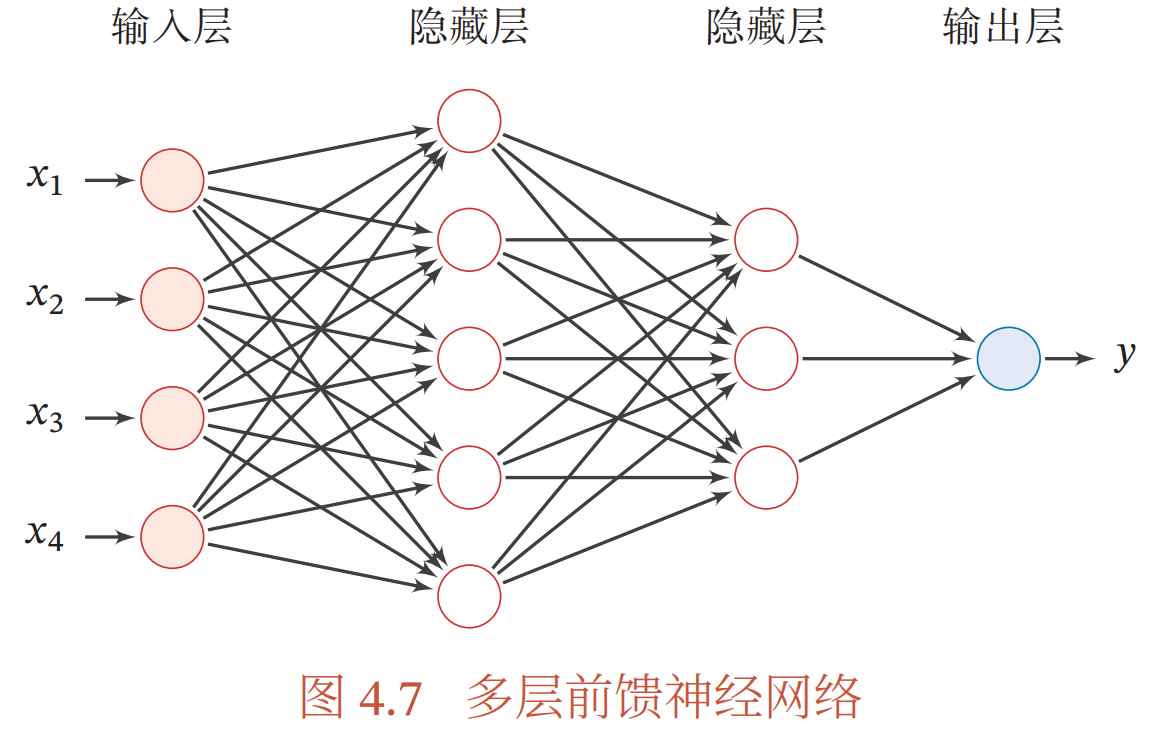
其具有以下特点:
- 各个神经元分属于不同的层, 层内神经元之间没有连接;
- 相邻层之间的神经元之间两两连接;
- 信号从输入层开始, 逐层单向传递, 直至输出层.
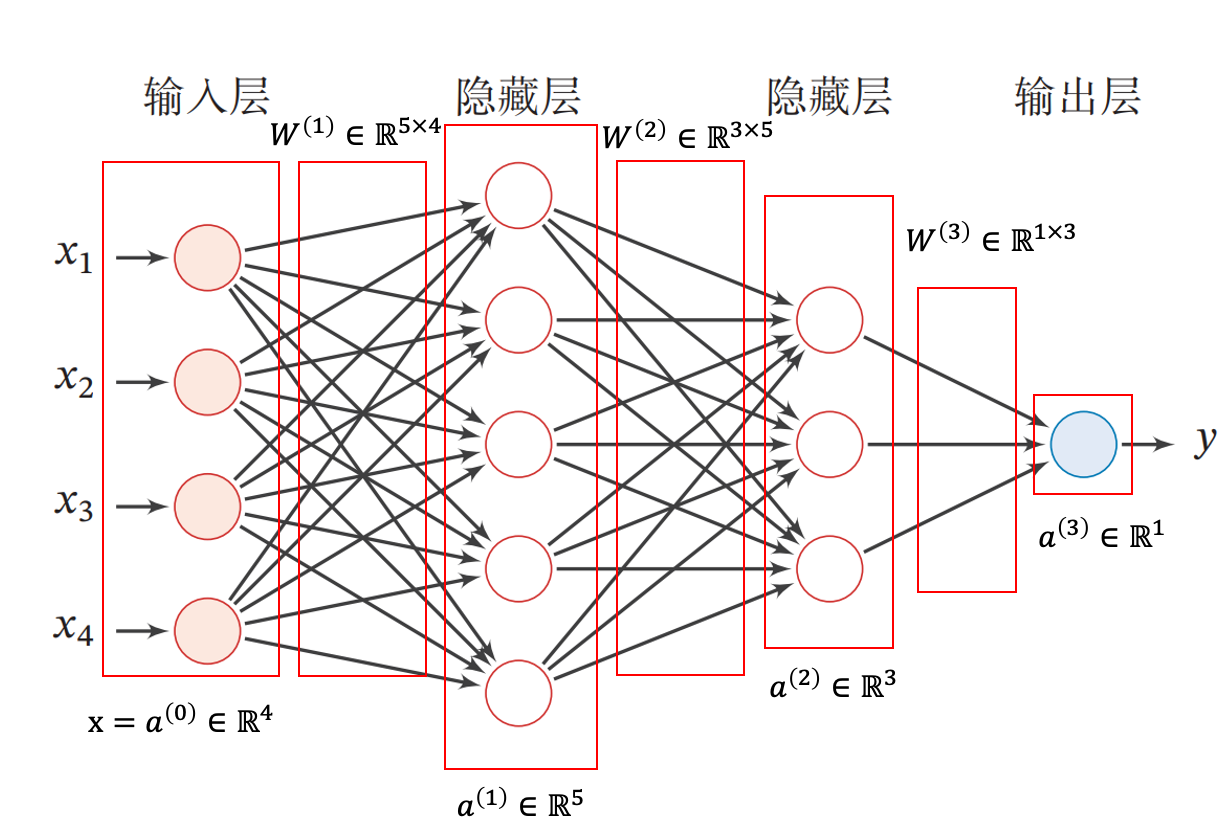
如果记一个这样的前馈神经网络的层数为 , 第 层的神经元个数为 , 则其一般的数学表达式为:
其中 是第 层到第 层的权重矩阵, 是第 层的偏置, 是第 层的激活函数, 是第 层的加权求和结果, 是第 层的激活输出.
若以图示的神经网络为例, 其数学表达式为:
本质上, 前馈神经网络就是一个复合函数: . 每个 都是一个简单的非线性函数, 但是通过复合, 可以构建出一个复杂的非线性函数, 从而提高了神经网络的表达能力. 事实上, 根据 Universal Approximation Theorem (Hornik et al., 1989), 两层的神经网络几乎可以拟合任意复杂的函数.
3.3 深度神经网络与模型训练
神经网络作为一个函数类具有良好的性质. 对于网络的深度的研究是当下的热点课题.
接下来的问题是模型训练, 即如何利用数据对模型的参数进行学习(估计). 我们最终学习到的神经网络本质上依然是一种函数映射:
其中 是模型的输出, 是输入, 是模型中所有待求解的参数. Generally speaking, 我们可以进一步定义一个损失函数 来衡量模型的预测值 与真实值 之间的差异, 从而定义模型的损失函数为:
如果我们有能力通过调整参数 来将损失函数最小化, 那么我们就可以得到一个较好的模型. 这个过程被称为模型训练.
一个典型的优化去寻找最小化的过程 (Gradient Descent) 如下:
其中 是学习率, 是损失函数关于参数的梯度. 因此, 模型训练的关键是如何计算损失函数关于参数的梯度.
3.4 反向传播算法 (Backpropagation, BP)
反向传播算法的本质是求解 的链式求导过程. Q某的吐槽:
- BP 的地位比较尴尬:
- 首先它确实很重要, 甚至一度推动了历史的进程;
- 但是现如今几乎完全被自动微分所取代, 实际中 的情况下不需要自己实现 BP.
详细的 BP 算法可以参考 http://cs231n.stanford.edu.
3.5 FNN 的 PyTorch from Scratch 实现 (以 XOR 问题为例)
下面我们以 XOR 问题为例, 通过 PyTorch 来实现一个简单的前馈神经网络. 这里使用两层的FNN. 可以看出输入的维度为 (即 ), 输出的维度为 (即 ), 样本量为 (即 ). 假设隐藏层的维度为 . 计算流程如下:
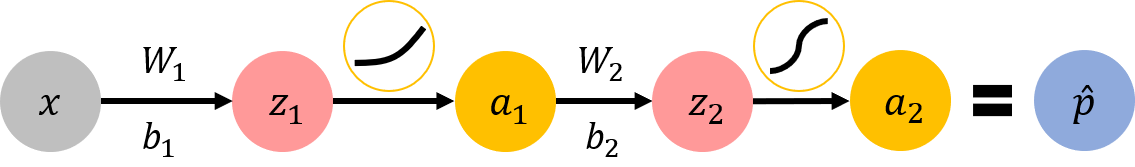
其中 为元素全为1的 向量, 为 矩阵, 为 向量, 为 矩阵, 为 向量。
模型定义
在 PyTorch 中, 本着模块化编程的原则, 一般会将模型定义为一个 python 中的类, 且继承自 torch.nn.Module.
import torch.nn as nn

class XOR(nn.Module): # 继承 nn.Module, 定一个 XOR 类作为模型
    def __init__(self, input_dim, hidden_dim, output_dim): # 定义初始化函数, 包括输入维度, 隐藏层维度, 输出维度
        '''
        初始化函数, 初始化模型各参数的维度和取值.
        - nn.Parameter() 用来声明这是模型的参数,稍后将参与求导,梯度更新. (即默认 requires_grad=True)
        - torch.randn(dim1, dim2) 用来生成一个形状为 (dim1, dim2) 的矩阵, 其元素是从N(0,1)中抽样
        - torch.rand(dim1, dim2) 用来生成一个形状为 (dim1, dim2) 的矩阵, 其元素是从U(0,1)中抽样
        '''
        super(XOR, self).__init__() # 调用父类 nn.Module 的初始化函数

        self.w1 = nn.Parameter(torch.randn(input_dim, hidden_dim)) # 输入层到隐藏层的权重
        self.b1 = nn.Parameter(torch.rand(hidden_dim, 1)) # 隐藏层的偏置
        self.w2 = nn.Parameter(torch.randn(hidden_dim, output_dim)) # 隐藏层到输出层的权重
        self.b2 = nn.Parameter(torch.rand(output_dim, 1)) # 输出层的偏置

    def forward(self, x):
        '''
        定义前向传播函数. forward() 函数是 nn.Module 的一个必须实现的函数,也是模型的核心. 在这个函数中我们定义了模型整体的向前传播过程 (即神经网络的拓扑结构 / 计算流程). 这里我们不调用内置的前馈网络, 而是从数学角度还原该前馈网络的计算过程.
        - x: 输入数据, 维度为 (n, p), 其中 n 为样本量, p 为特征数
        - torch.matmul(X, Y) 用来计算矩阵 X 与 Y 的矩阵乘法

        '''

        n = x.shape[0]  # 通过输入 x 的维度获取样本量 n
        onevect = torch.ones(size=(n,)).view(n,1) # 生成一个 n*1 的全1向量,以配合偏置项
        z1 = torch.matmul(x,self.w1) + torch.matmul(onevect,self.b1.t())  # 计算隐藏层的加权求和
        a1 = torch.nn.functional.softplus(z1) # 计算隐藏层的激活输出
        z2 = torch.matmul(a1,self.w2) + torch.matmul(onevect,self.b2.t())  # 计算输出层的加权求和
        a2 = torch.nn.functional.sigmoid(z2) # 计算输出层的激活输出

        return a2

torch.random.manual_seed(123456) # 设置随机种子, 保证结果可复现
model = XOR(input_dim=2, hidden_dim=3, output_dim=1) # 调用刚刚定义的 XOR 类, 初始化模型. 模型的超参数中, 输入维度为 2, 隐藏层维度为 3, 输出维度为 1. 模型输入一个符合维度的数据 X, 就将输出一个符合维度的预测值 Y (这是在 forward() 函数中定义的).
print(list(model.parameters())) # 查看模型的参数
模型训练
from tqdm import tqdm # 用来显示训练进度条(optional)

# --- 训练初始化 ---

# 迭代次数
nepoch = 10000
# 学习率,即步长
learning_rate = 0.1
# 记录损失函数值
losses = []

opt = torch.optim.SGD(model.parameters(), lr=learning_rate) # pytorch提供了一个优化器,对于model这个对象里的所有参数进行优化

pbar = tqdm(range(nepoch)) # 定义一个进度条

# --- 训练过程 ---

for i in pbar: # 迭代训练 (如果没有进度条, 可以直接写 for i in range(nepoch))
    a2 = model(x) # 前向传播, y = a2 = model(x) 相当于 f(x; \theta)
    loss = -torch.mean(y * torch.log(a2) + (1.0 - y) * torch.log(1.0 - a2)) # 计算损失函数, 这里手动计算交叉熵损失函数

    opt.zero_grad() # 梯度清零. 这是很重要的一步, 在每次更新参数之前都需要将梯度清零, 否则梯度会累加
    loss.backward() # 反向传播计算梯度
    opt.step() # 根据梯度更新参数

    losses.append(loss.item()) # 记录损失函数值到 losses 列表中
    pbar.set_description("loss: %s" % loss.item()) # 在进度条中显示损失函数值

# --- 训练结果 ---
print(a2) # 输出模型的预测值
在本地的一次训练结果如下:
tensor([[7.4539e-04],
        [9.9768e-01],
        [9.9907e-01],
        [1.1904e-03]], grad_fn=<MulBackward0>)
对应的真实值应当为:
tensor([[0.],
        [1.],
        [1.],
        [0.]])
还是比较理想的.