References
- Reading: Dive into Deep Learning (D2L), Chapter 7
1. From Fully Connected to Convolutions
CNN 常常用来处理图像数据. 对于图像而言, 其可以看做是一个高维的张量.
- 对于灰度图像, 其可以看做是一个二维的矩阵, 每一个元素代表一个像素的灰度值, 可以简化地认为 , 其中 和 分别表示图像的高度和宽度, .
- 对于彩色图像, 其可以看做是一个三维的张量, 每一个元素代表一个像素的 RGB 值, 可以简化地认为 , 其中 表示通道 (channel) 数 (对于 RGB 图像, ). 某种意义上可以认为是三个 的矩阵堆叠在一起, 每一层代表一个通道 (例如红色通道, 绿色通道, 蓝色通道).
在面对图像处理数据时, 若按照全连接层的方式处理, 我们会直接将图像展平为一维向量, 这会导致大量的参数, 且忽略了图像的空间结构信息 (例如相邻的像素之间的相关性).
- 一般而言全连接层的前馈神经网络更适合一般的 tabular 数据.
- 例如, 对于一个 的灰度图像, 其包含了 个像素. 即使只使用一个隐藏层且神经元数量同为 , 其参数数量也会达到 (其中 为权重矩阵, 为偏置向量).
因此, 我们需要一种新的方法来处理图像数据, 这就是卷积神经网络 (CNN) 的由来.
- 其利用了图像间的空间结构信息和局部的相似性
- 其参数数量少, 计算效率高
- 其计算的过程也容易使用 GPU 进行并行化
CNN 为什么适合图像处理? (图像处理任务的特点)
- Translation Invariance (平移不变性): 在图像识别的网络的前期, 我们不关心图像中物体的具体位置, 只关心物体的存在与否. 例如, 对于一个猫的图像, 我们不关心猫在图像中的具体位置, 只关心图像中是否有猫.
- Locality Principle (局部性原则): 在图像识别的网络的前期更应当关注图像中局部的特征, 而不是全局的影响. 例如, 对于一个猫的图像识别, 我们更应当关注猫的耳朵, 眼睛, 鼻子等局部特征, 而不是整个图像的颜色分布.
- Hierarchical Feature Learning (分层特征学习): 通过多层的卷积操作, CNN 可以学习到从低级特征 (例如边缘, 角点) 到高级特征 (例如物体, 场景) 的分层特征表示. 这使得 CNN 在图像识别任务中具有更强的表达能力.
上述结构的数学表达
-
假设我们的输入图像为 的灰度图像, 其像素值如下:
对应想要求解的隐藏层输出为
-
此外, 偏置为 , 权重为 是一个四维张量: 对于每一个输出位置 , 我们都有一个对应的权重矩阵 . 例如在 处, 权重矩阵为:
-
因此对于最直接的 fully connected layer, 我们在第 行 列的输出 可以表示为:
-
若要满足 Translation Invariance, 我们需要将权重矩阵 进行共享, 使得对于任意的 , 都有:
这样我们就可以将上面的公式简化为:
-
若要满足 Locality Principle, 我们需要将权重矩阵 的大小进行限制, 使得其只包含局部的像素值. 例如, 我们可以设置一个邻域范围 , 使得在 处的输出只依赖于 到 之间的像素值, 而在该范围之外的元素之权重为 0.
- 例如, 我们可以设置 , 使得 , 这样我们就可以将上面的公式简化为:
- 这时的时间复杂度为
2. Key Elements of CNNs
Kernel (卷积核)
通过引入这样的局部连接, 我们可以将卷积操作 (convolution) 进行简化. 而这里的 就是我们所说的卷积核 (convolutional kernel), 其大小为 (例如 ), 其在图像上进行滑动, 每次滑动一个像素, 计算卷积操作.
如果输入的图像大小为 , 卷积核的大小为 , 那么输出的大小为:
Channels (通道)
对于图像数据, 我们可以将其看做是一个三维的张量, 其中每一个通道 (channel) 都可以看做是一个二维的矩阵. 而这时的数学表达式就变为:
- 其中 表示通道数 (例如对于 RGB 图像, ), 表示第 个通道的偏置.
Receptive Field (感受野) 感受野 (receptive field) 是指在卷积神经网络中, 某一层的神经元所能感知到的输入数据的区域.
- 例如在如下简易卷积操作中:
- 其中, 输出的每一个元素都可以看做是输入的一个感受野 (receptive field) 的加权和. 例如, 输出的第一个元素 就是 receptive field 的加权和, 其对应的权重为 .
随着卷积层的加深, 感受野的大小也会逐渐增大. 在深层的卷积层中的一个神经元的感受野可能会覆盖整个原始的输入图像. 这使得 CNN 可以学习到更高级的特征表示, 例如物体的形状, 纹理等.
3. Padding and Stride
3.1 Padding (填充)
在卷积操作中, 对于没有填充的卷积操作, 输出的大小会比输入的大小小 (输出边长为: ). 这会导致在多层卷积操作中, 输出的大小会逐渐减小.
- 例如, 对于一个 的图像, 如果我们使用 的卷积核进行卷积操作 次, 那么输出的大小为 .
为了解决这个问题, 我们可以在输入的边缘进行填充 (padding), 使得输出的大小不变.
- 例如对于上述的 的输入, 我们可以在输入的边缘进行 像素的填充:
设定输入的大小为 , 卷积核的大小为 , 填充在height方向一共填充 个像素, 在width方向一共填充 个像素, 那么输出的大小为:
特别地, 有时我们希望输出的大小和输入的大小相同, 这时我们可以设置 和 , 即 和 . Practically,
- 若 为偶数, 则在上面和下面各填充 个像素
- 若 为奇数, 则在上面填充 个像素, 在下面填充 个像素
3.2 Stride (步幅)
Stride 是指卷积核在输入图像上滑动的步幅或间隔. 这也是一种控制输出大小的方法. 当输入的大小较大而卷积核较小时, 我们可以通过增大步幅来减少输出的大小. Stride 越大, downsampling 的效果越明显.
对于输入的大小为 , 卷积核的大小为 , 填充在height方向一共填充 个像素, 在width方向一共填充 个像素, 步幅在height方向为 , 在width方向为 , 那么输出的大小为:
- 其中 表示向下取整 (当下次移动会超出边界时, 该位置的输出不计算).
4. Multi-Channel Convolution
对于多通道的卷积操作, 我们每个通道都会有一个对应的卷积核, 其大小为 . 因此, 假设输入的 channel 数为 , 则共需要 个卷积核, 一共的参数数量为 . 每个 channel 的卷积操作都是独立进行的, 最后将每个 channel 的卷积结果进行相加, 得到最终的输出.

但是这样的一个问题是我们的通道数量也在不断减少(因为最后都被相加了). 在 CNN 中, 一个通常的做法是我们会不断减少整个范围的大小 , 但是会增加通道的数量以增强特征的表达能力. 因此上图的卷积操作还可以重复 次, 得到 个输出对应着 通道. 因此每个输入通道需要 个卷积核, 每个卷积核的大小为 , 一共定义了 个输出通道, 我们需要 个参数.
例: 对一个 的图像进行卷积操作, 卷积核大小为 , 则输出的大小为 .
Convolution
卷积操作是指卷积核的大小为 , 其主要的目的是对输入的通道进行线性组合, 对同一个位置不同通道的像素进行加权和, 因此其也可保持输出的长宽不变.
因此也可以认为其是一个对于每个像素位置整合所有通道的一个全连接层, batch size 为 .

5. Pooling
Pooling 是指在卷积操作后, 对输出的结果进行下采样 (downsampling) 的操作. 其形式上和 kernel 的操作类似, 但是其并不包含可学习的参数. 典型的 pooling 操作有:
- Average Pooling: 取出当前区域内的平均值. 其起到了平滑的作用. 但是, 在实际中 average pooling 的效果可能不佳, 因为其可能会导致一些重要的特征被平滑掉.
- Max Pooling: 取出当前区域内的最大值. 在实际中 max pooling 的效果通常会更好, 因为其可以保留一些重要的特征.
Pooling in Multi-Channel Convolution 在多通道的卷积操作中, 我们对每个通道的卷积结果进行 pooling 操作, 但不会对 pooling 的结果进行汇总. 换言之, pooling 操作是对每个通道的卷积结果进行独立的下采样操作, 并不会减少通道的数量.
6. Xavier Initialization for CNNs
Xavier Initialization 是一种用于初始化神经网络权重的方法, 其主要目的是为了避免在训练过程中出现梯度消失或梯度爆炸的问题. 其主要的思想是根据输入和输出的大小来初始化权重, 使得每一层的权重为0均值, 方差为 的某种随机分布, 其中 和 分别表示输入和输出的大小. 这样可以使得每一层的输出都在一个合理的范围内, 避免了梯度消失或梯度爆炸的问题. 在实践中, 我们通常会使用均匀分布
因为正态分布可能会更倾向于让权重集中在0 附近, 而均匀分布则可以让权重更均匀地分布在整个范围内.
在 CNN 的场景中, 假设我们的 kernel 大小为 , 输入的通道数为 , 输出的通道数为 , 则我们的输入和输出的大小分别为
- 因此我们可以将权重初始化为均匀分布 .
7. LeNet
LeNet 由 Yann LeCun 等人提出 (最终版本 LeNet-5 于 1998 年发表), 是最经典的用于手写数字识别的卷积神经网络. LeNet-5 是其中最著名的一个变种, 其包含了 2 个卷积+Pooling 层和 3 个全连接层. 其结构如下:
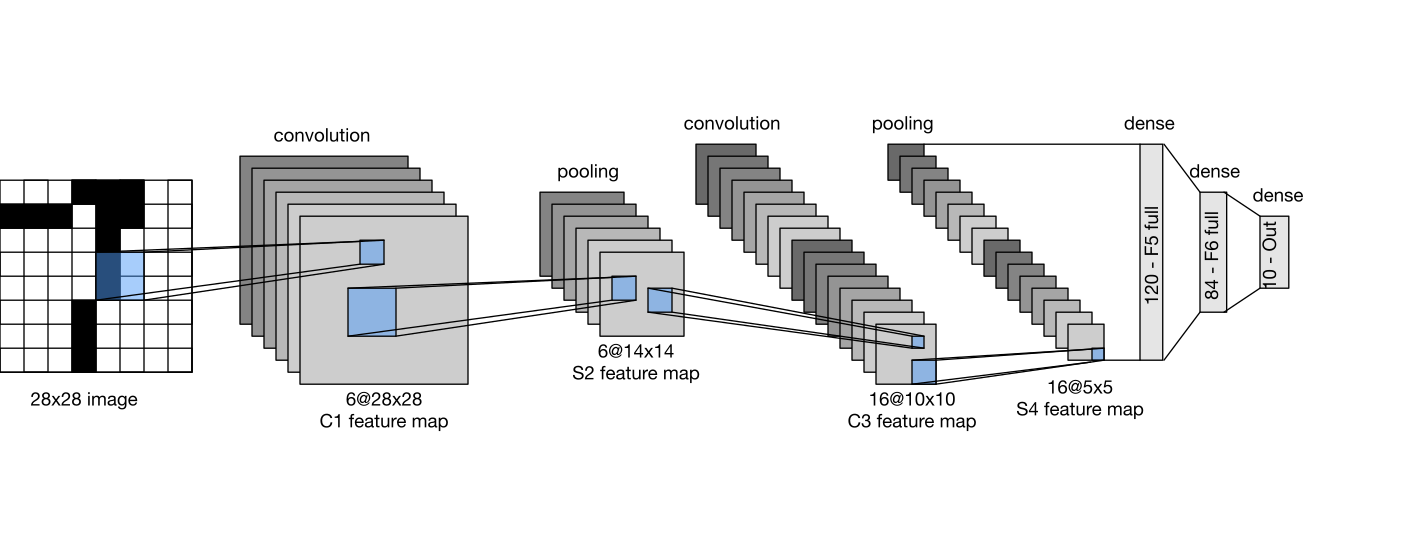
- 在 LeNet-5 中, 其使用的是 average pooling 和 sigmoid 激活函数. 这包含一定的局限性.