References
- Lecture: 李宏毅, 生成式 AI 時代下的機器學習 (2025), https://youtu.be/gjsdVi90yQo?si=fNjhGg7DtaOy09ZU
1. Every Architecture Has Its Own Reason to Exist
每一种架构都有一个存在的理由.
对于 RNN, Self-Attention, Mamba, etc. 这一系列的架构, 其核心都是在处理与序列相关的任务. 对于输入 , 对应输出 . 其中又通常会有因果性的要求, 即输出 只能依赖于 及其之前的资讯.
1.1 RNN-Style Architecture
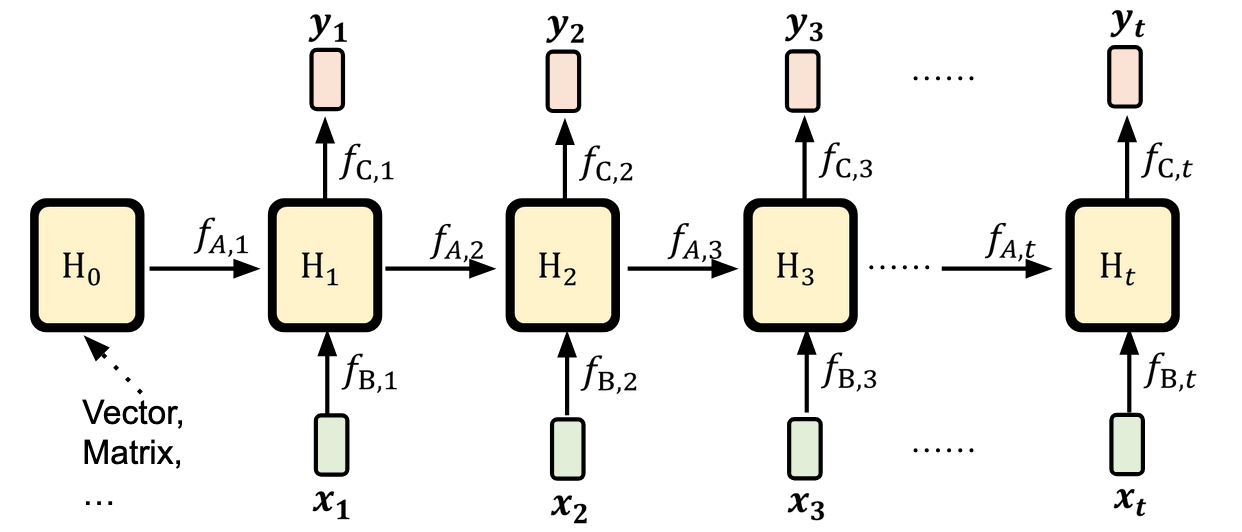
对于循环神经网络类, 其核心在于维护一个 hidden state 作为记忆, 其更新方式为:
再通过另一个函数 进行输出:
其中 都是神经网络, 并且可以根据时间 (输入序列的位置) 的不同而不同. 例如 LSTM 中, 对应 input gate, 对应 forget gate, 对应 output gate.
1.2 Self-Attention
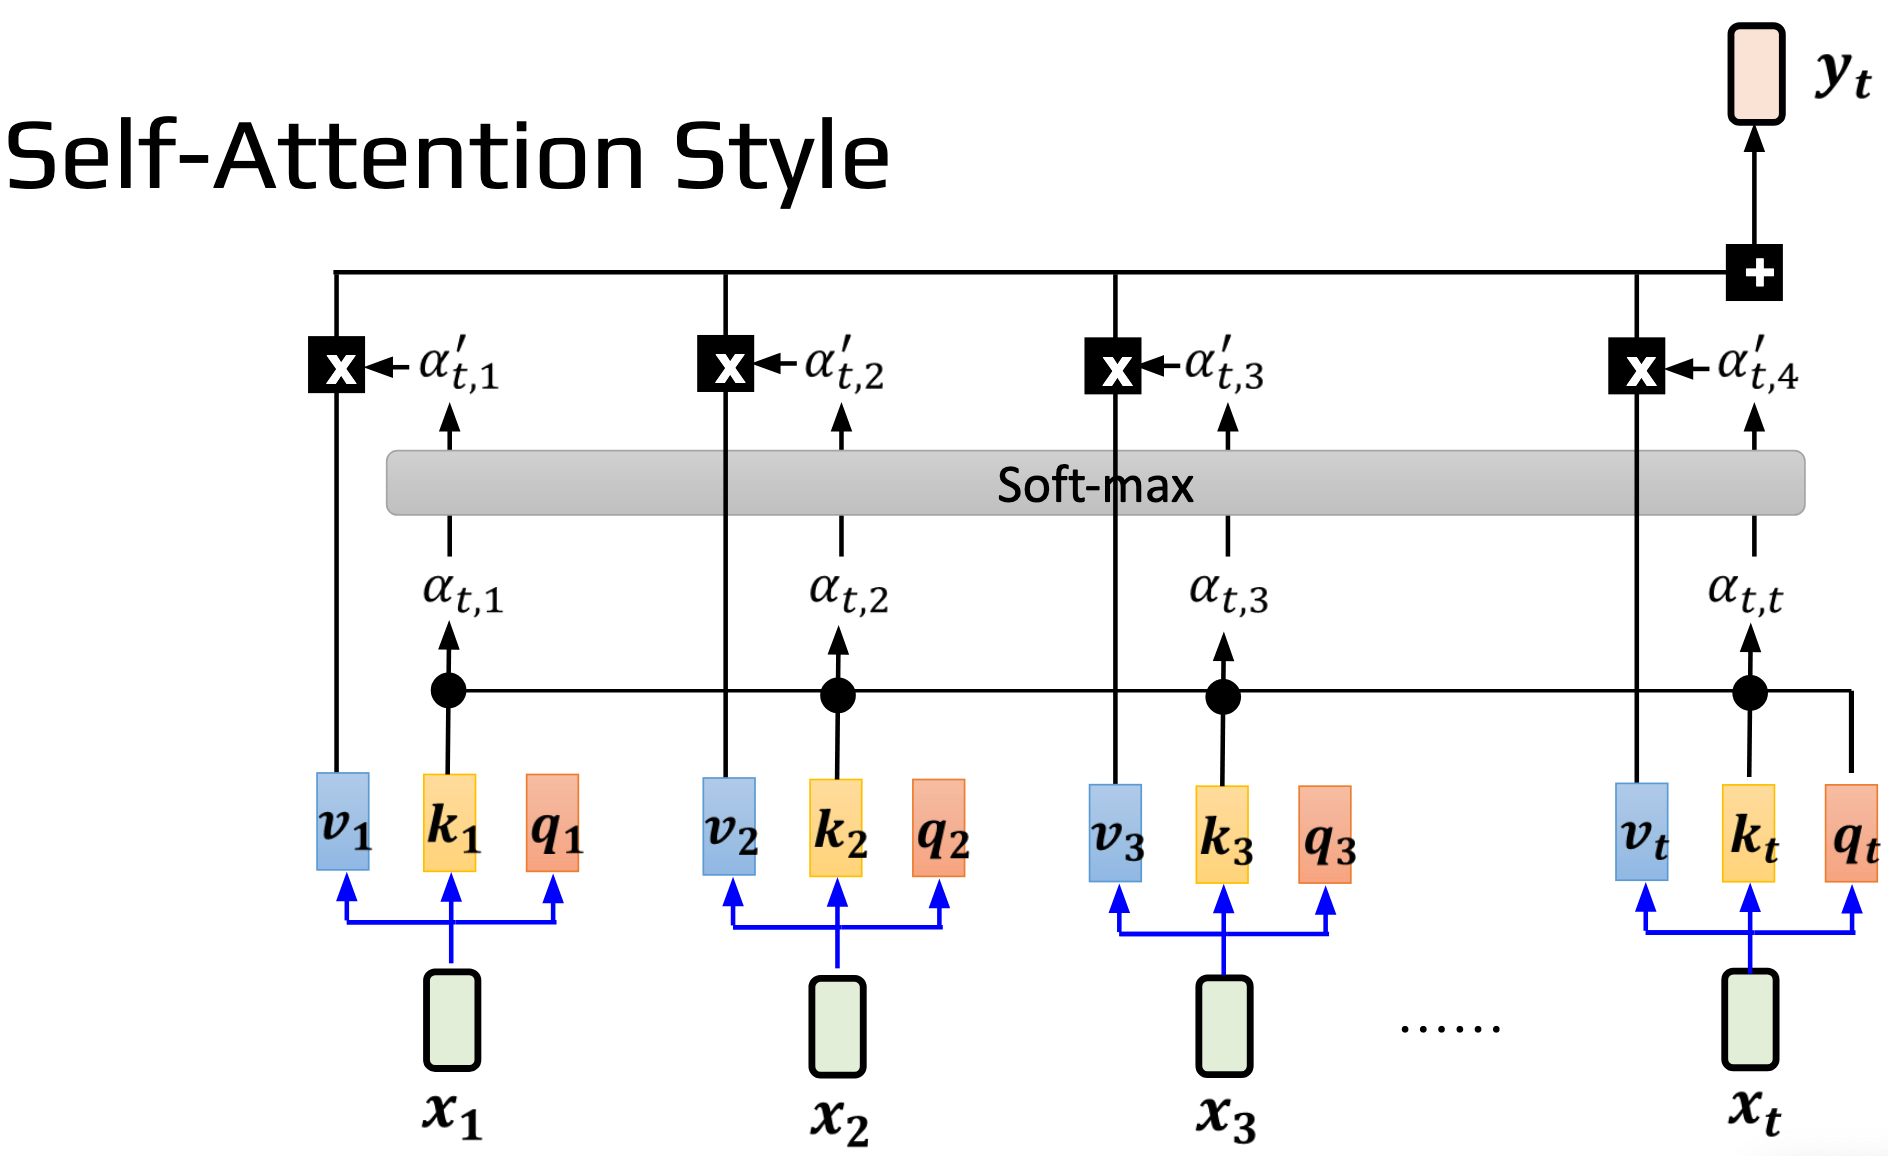
Self-Attention 与 RNN 在 inference 时的区别在于: 对于 RNN, 其每一步的运算量都是恒定的. 但是对于 Self-Attention, 其运算量是随着输入序列的长度增加而增加的. 并且对于 RNN, 当我们需要 的输出时, 我们只需要 即可. 但是对于 Self-Attention, 我们需要 的所有信息才能计算 . 这就导致了 Self-Attention 的内存开销也是随着输入序列的长度增加而增加的.
而另一方面, 在 training 时, Self-Attention 的优点在于可以并行化. 这主要是通过 Shifted Input 和 Masked Attention 来实现通过并行的方式模拟序列的输入输出. 此外其架构的设计更好地利用了 GPU 的并行计算能力. 这也是为什么近年 Transformer 取代 RNN 成为主流的原因.
1.3 From Transformer to Mamba
随着大语言模型的不断发展, 我们输入的 input 的长度也越来越长. 这就导致了 Self-Attention 的内存开销也越来越大, 而 RNN 在 inference 时的优势也越来越明显. 因此这就抛出了一个问题: RNN 真的没有办法并行化吗?
1.3.1 RNN 的并行化设计
回顾其架构:
假设 , 则上面的 RNN 架构可以展开为:
而在上述架构中, 最耗费时间的部分是一系列嵌套的 的计算. 一个解决方法是令 为 identity function (即 ), 这样就可以将其展开为:
进一步作如下假设: 假设 , , , 其中 . 则此时可以将其展开为:
且
若再假设 , 其中 , , 则可以将其展开为:
这正是 Self-attention 的形式! 唯一的不同就是没有进行 Softmax. 这里称之为 Linear Attention.
因此我们现在有如下认知:
- Linear Attention 就是广义 RNN 去掉了 Reflection
- Linear Attention 就是 Self-Attention 去掉了 Softmax
因此我们就可以在 Inference 时将其理解为一个 RNN, 但是在 Training 时当作(没有Softmax 的) Self-Attention 来训练. 这样就可以在 Inference 时达到 RNN 的效果, 但是在 Training 时又可以利用 Self-Attention 的并行化优势.
1.3.2 Linear Attention
Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention (https://arxiv.org/abs/2006.16236)
这里梳理一下 Linear Attention 的计算过程:
其中 . 这里 都是可学习的参数.
因此对于 hidden state , 其更新的方式为:
直观的理解为, 是希望在时刻更新到 hidden state 的信息, 而 决定了这笔资讯加入 hidden state 的位置. 例如, 一个极端例子若 , 则 只会更新到 的第一维, 而其他维度不变. 当然在更一般的情况下可以分散到多个维度上.
而最终的输出 为:
这在直观上可以理解为, 是我们维护到目前为止的所有信息, 不同的维就对应着不同的信息. 而 则决定我们从每个维度要提取多少的信息. 若同样的 , 则 只会提取到 的第一维.
1.3.3 RNN 与 Transformer 的记忆
一个普遍的认知是, 由于 hidden state , 因此其记忆的容量是有限的. 而 Transformer 由于其可以一直读取到整个序列, 因此其记忆的容量看似是无限的. 但是事实并非如此.
在 Transformer (Self-Attention + Softmax) 中, 每个输入 都会对应 Q, K, V: , . 当当前序列的长度 时, 我们总能设计出一组合理的 使得每一笔资讯都能被良好存储. 然而当 时, 对于一个 维向量, 我们最多只能找到 个正交的向量, 而对于其余的向量, 我们总能将其表示为其他向量的线性组合. 这也就导致了即使我们只想提取某个时刻 的资讯, 但是由于 的总长度过长, 也总会存在其他的杂讯 使得 的值过大, 引入了我们并不需要的 value . 这也就导致了 Transformer 的记忆容量是有限的.
因此, 在实践中 RNN 的效果不如 Transformer 的原因可能并不是因为其记忆容量有限, 而是因为 Linear Attention 的设计中 对已有的输入 不会遗忘, 已有的记忆不会再发生改变. 而在 Transformer (Self-Attention + Softmax) 中, 正是因为有了 Softmax 的设计, 使得每次有了新的资讯的时候, 全部的已有信息的重要性 (attention score) 都会被重新加权计算, 这也就给了 Transformer 更大的灵活性和对历史更新的能力.
1.3.4 可遗忘的 Linear Attention
RetNet
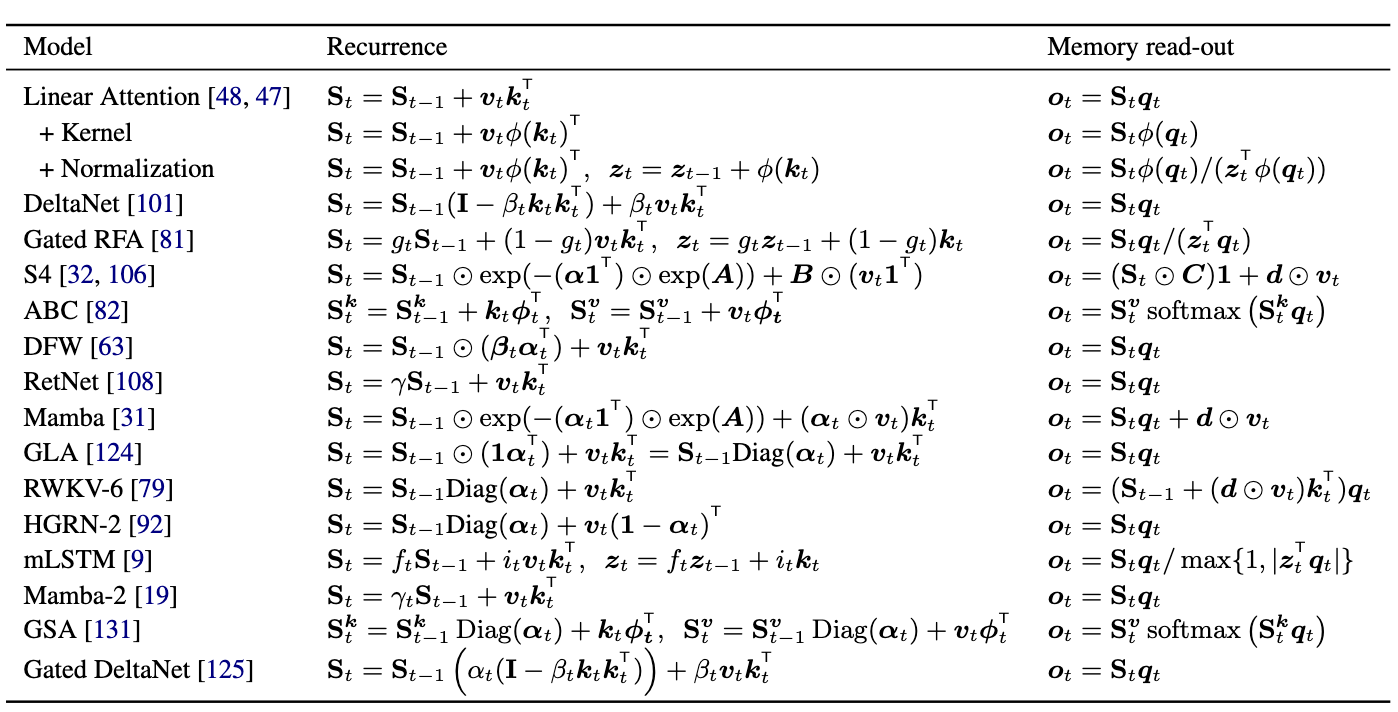
鉴于 Linear Attention 的一个弊病就是无法遗忘已有的记忆, 因此我们可以设计一个 Retention Network 来解决这个问题:
其中 是一个衰减参数.
Gated Retention
甚至更进一步, 让这个衰减参数 也可以是时变的:
其中 , 是可学习的参数. 这样就可以在每个时刻都可以选择是否要遗忘已有的记忆.
更复杂的 Reflection
甚至可以设计一个更复杂的 Reflection:
其中 是可学习的.
类似的设计还有很多, 而 Mamba 也是其中之一.
1.3.5 Delta Net
DeltaNet: Parallelizing Linear Transformers with the Delta Rule over Sequence Length (https://arxiv.org/abs/2406.06484)
在 DeltaNet 中, 其 hidden state 的更新方式为:
该设计的初衷如下. 当我们想要去对 hidden state 进行更新时, 事实上 的对应位置也是已经有一些历史的记忆了. 因此这里希望首先识别并清除掉历史的记忆 , 再写入新的记忆:
这里 是可学习的参数表示遗忘的程度.
然而这里的最后一个式子:
在某种意义上就是一个 Gradient Descent ! 其中 就是学习率, 而 是
之梯度. 而这个loss function的含义就是, 在我们更新 hidden state (即memory) 的时候, 我们希望通过 抽出的资讯和 尽量接近.