References
- Reading: Dive into Deep Learning (D2L), Attention Mechanisms and Transformers
- Lecture: 李宏毅, 机器学习, https://speech.ee.ntu.edu.tw/~hylee/ml/2021-spring.php
- Lecture: 李宏毅, 2025 Deep Learning
1. Introduction
Transformer 是当代 NLP 领域最重要的模型之一. 其在处理 Sequence-to-Sequence 任务时取得了巨大的成功. 与传统的循环神经网络不同, Transformer 使用了 Self-attention 的机制来捕捉序列中的依赖关系, 以改进在传统循环神经网络中的长距离依赖问题.
本文将从 Attention 机制开始介绍 Transformer 模型的各个组成部分, 最终介绍 Transformer 的整体结构.
注: 本章涉及到的符号记号较多, 有时不同小节之间的同一个记号可能有不同的含义或矩阵形状. 尽管每次涉及到符号的地方都会进行说明以避免误解, 但对阅读造成的不便还请谅解.
2. Query, Key, Value
这里将在一个翻译的语境中介绍 Attention 机制. 在翻译任务中, 我们需要将一个句子翻译成另一个句子.
我们有如下 key-value 对:
其中 是 key (类似于词典中的word), 是 value (类似于词典中的word 对应的含义).
给定一个查询 query , 我们可以计算 query 和 key 的相似度:
其中 是 和 的一种相似度度量, 也称为 attention score / weight. 因此这个机制可以看作, 当我们有一种查询 时, 我们可以遍历字典 中的所有 keys, 并且根据 query 和 key 的相似度给予每个 key 对应的 value 不同的权重.
某种意义上, 这个机制可以看作是一种加权平均, 或称为 attention pooling. 相当于我们翻阅了整个字典, 并且根据查询的不同给予不同的词汇不同的权重, 最终根据这些权重计算出一个加权平均的结果作为对 query 的回答.
- 很自然的, 我们可以将 看作是一个权重, 因此希望这些权重的和为 1 且每个权重都是非负的. 为了满足这个条件, 我们可以使用 softmax 函数: 其中 可以是任意的一种相似度度量, 例如内积, 余弦相似度等.
这种机制也让我们可以在大型数据集上进行查询.
3. Attention Pooling by Similarity
一个前神经网络的想法是借用 Nadaraya-Watson Kernel Regression 的思想, 通过一些 determined 的 kernel 来计算 query 和 key 的相似度. 例如:
- Gaussian Kernel:
- Boxcars Kernel:
- Epanechnikov Kernel:
进一步将这些权重进行加权平均:
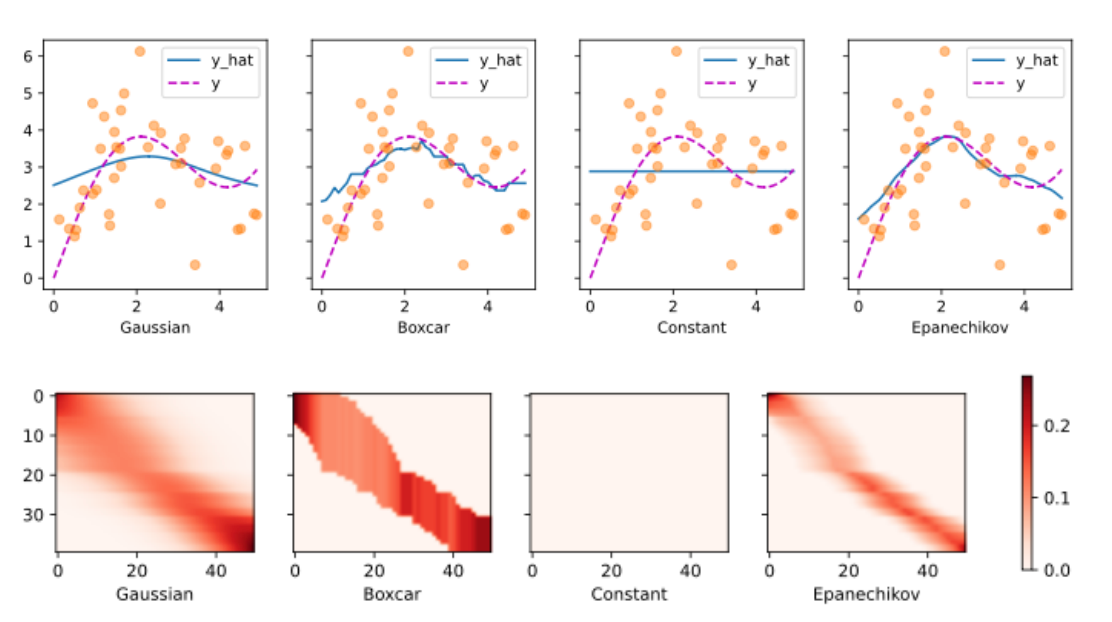
不论是使用何种 kernel, 其本质都是在直接的衡量 query 和 key 之间的某种距离, 并赋给距离较近的 key 更大的权重. 但是这种方法过于依赖 kernel 的选择. 一个更好的方法是使用学习的方式来“学习” 出一种合适的 kernel, 或者更广义的说, 一种合适的相似度度量.
4. Attention Scoring Functions
Attention 机制的核心是如何计算 query 和 key 之间的相似度, 并且根据这个相似度给予 key 对应的 value 不同的权重.
4.1 Scaled Dot-Product Attention
在实践中, 内积的计算是较为 costly 的, 因此我们希望能够简化 attention score 的计算. 考虑如下的 Gaussian Kernel:
如果考虑 Softmax 的形式, 我们可以将其写成:
- 首先注意到 是可以被消去的
- 其次, 若我们在训练中引入 Batch & Layer Normalization, 则一般而言 也约等于一个常数, 因此也可以被消去
- 因此我们最终会用 作为相似度度量
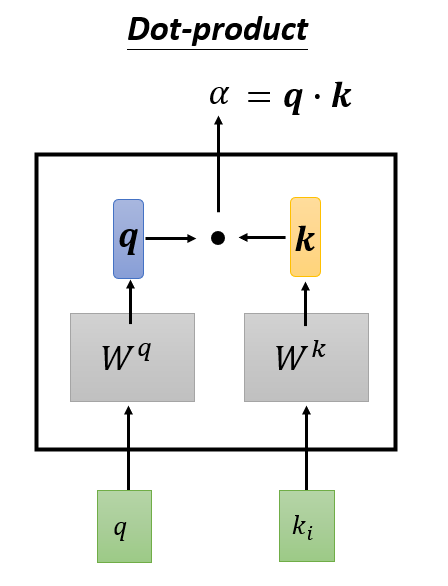
进一步, 为了控制模型的 magnitude (即使得模型更稳定), 我们可以引入一个 scale factor , 即 .
- 的选择是基于如下考虑: 假设 和 的各个元素都是独立的, 且服从均值为 0, 方差为 1 的分布. 因此对于内积 , 其期望值为 0, 方差为 . 因此除以 相当于除以这个内积的标准差, 使得其期望值为 0, 方差为 1.
因此, 最终得到的 Softmax Attention 机制为 (或称为 Scaled Dot-Product Attention):
上面是针对一个 query 的计算, 对于多个 queries, 我们可以将其写成矩阵的形式.
考虑 个 queries , 个 key-value pairs , . 这里强调一下各自的维度: 对于每一个 key, 我们都会对应着一个 value, 因此 和 的第一个维度(行数)是相同的, 都是 . 对于每一个 query, 我们都需要和一个观测中的所有 key 进行比较, 因此 和 的第二个维度(列数, 即特征数)是相同的, 都是 . 而我们对于 query 的请求次数, 以及 value 的表示的维度是没有要求的, 因此 的行数是 , 的列数是 .
则我们可以计算出所有 queries 和 keys 之间的相似度:
并且得到最终的关于所有 queries 的加权平均:
4.2 Additive Attention
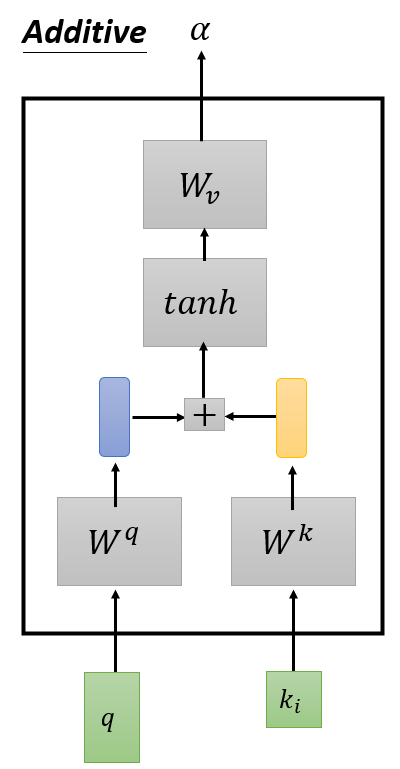
除了 Scaled Dot-Product Attention 之外, 我们还可以使用 Additive Attention. 对于一条 query , key , 二者有时可能不在同一个空间中 (例如 和 的维度不同). 因此我们可以通过一个全连接层来将其映射到同一个空间中, 并且再计算相似度. 在数学上可以理解为引入可学习的权重矩阵 , , 并且计算如下:
再通过 Softmax 函数进行归一化:
[Q&A] Which of the following is not a difference between scaled dot product attention and additive attention?
- Additive attention can be applied to queries and keys of different lengths but scaled dot product attention cannot.
- Additive attention has learnable parameters but scaled dot product attention does not.
- Scaled dot product attention weights are normalized to sum to 1 but additive attention weights are not.
- Scaled dot product attention scoring function has unit variance but additive attention scoring function does not.
5. Bahdanau Attention
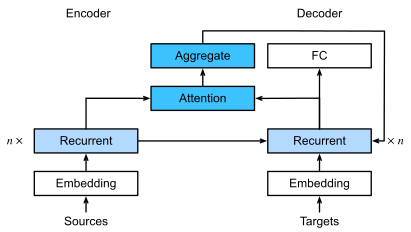
Bahdanau Attention 是早期一种经典的 attention 机制, 被用来解决例如翻译的具体 Sequence-to-Sequence 任务中. 其同样有 Encoder 和 Decoder 两个部分. 具体而言,
- 我们有一个输入序列 , 和有监督学习对应的输出序列 .
- 首先通过 Embedding 层将输入序列映射到 . 对应的解码器会对应每个时间步输出 作为输出label 的hidden state.
- Bahdanau Attention 机制会对输入序列中的每个位置 产生一个对当前输出位置 的 attention score ( 是一个经过归一化的可学习的 attention scoring function, 如MLP).
- 我们按照得到的 attention score 对序列进行加权平均, 并且将其作为当前时间步的 context vector :
- 最终我们将 context vector 和当前时间步的 hidden state 通过一个全连接层进行整合, 并且输出当前时间步的预测结果 .
6. Multi-Head Attention
多头注意力机制是 Transformer 中的一个重要组成部分. 其本质是将同样构造的注意力机制平行的引入 份 (每一份即为一个 head) , 并行地对输入进行处理, 并将结果进行拼接. 这样的机制可以让模型更好地捕捉到不同的特征 (每个 head 可以学习到不同的特征) 或序列的不同的重要部分.
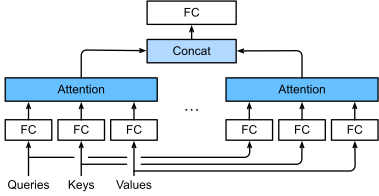
数学上, 假设 , 我们可以将其复制为 份, 并且对每一份 (每个 head) 分别进行计算:
其中 是可学习的参数矩阵, 是一个 attention pooling 函数.
最后我们将所有的 拼接起来:
并且再通过一个可学习的参数矩阵 (即再通过一个全连接层) 进行线性变换汇总为最终的输出:
7. Self-Attention
假设我们有一个 token 序列 , 其中 . Self-Attention 简要的说就是序列自己和自己中的每一个 token 做 的 attention 操作. 一个关键的 takeaways 是, Self-Attention 机制可以捕捉到序列中的依赖关系, 并且会输出一个和输入序列同样长度的序列.
数学上可以概括地表示如下. 考虑输入序列 , self-attention 可以输出一个同样长度的序列 , 其中:
其中 是某种 attention pooling 函数. 且注意到, 我们在计算 self-attention 时, 也会计算 和 自己之间的相似度, 并且给予不同的权重.
- 事实上, self-attention 模块的输入(和输出)也并不一定要作为原始的输入(或最终的结果). 就 self-attention 的输入而言, 其既可以是一个原始序列, 也可以是上一个隐藏层的输出.
7.1 Self-Attention 的计算过程
通过下图的示意图再详细梳理一下 Self-Attention 的计算过程.
-
首先计算 attention score (方便起见, 这里我们使用 dot-product attention):
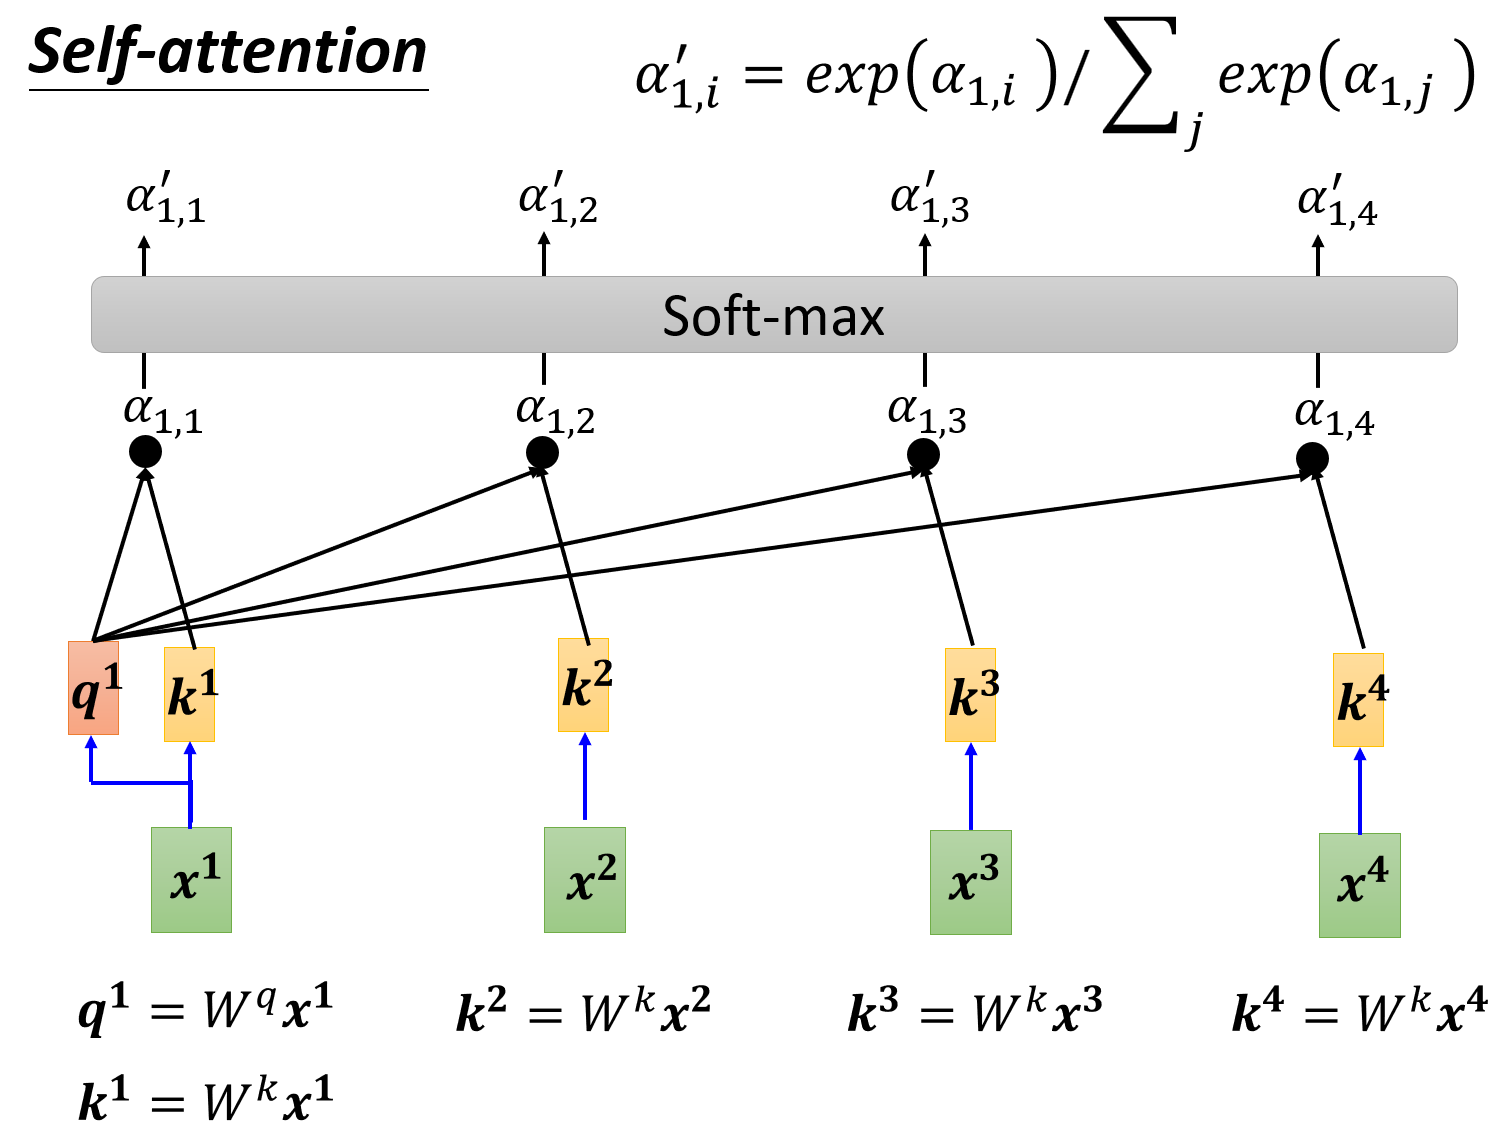
- 对于输入序列 , 我们分别通过一个线性层 (即可学习的矩阵 ) 将输入序列分别映射到 和 .
- 然后每次取一个 query (图中以 为例), 并且和所有的 key 进行计算相似度 (即我们通过 dot-product 或者 additive attention 定义的 attention score), 记之为 .
- 为了保证 attention score 是一个合理的权重, 再将其通过 softmax 函数进行归一化, 对应得到的权重为 (注意这里的 softmax 是针对每一个给定的 query , 对所有的 key 进行归一化).
- 当然这里的 softmax 是当时提出该方法的时候选择的一个归一化函数, 但实际上也可以选择其他的归一化函数
- 在实作中这里还会再除以 , 以控制模型的 magnitude.
-
接着根据 attention score 计算加权平均:
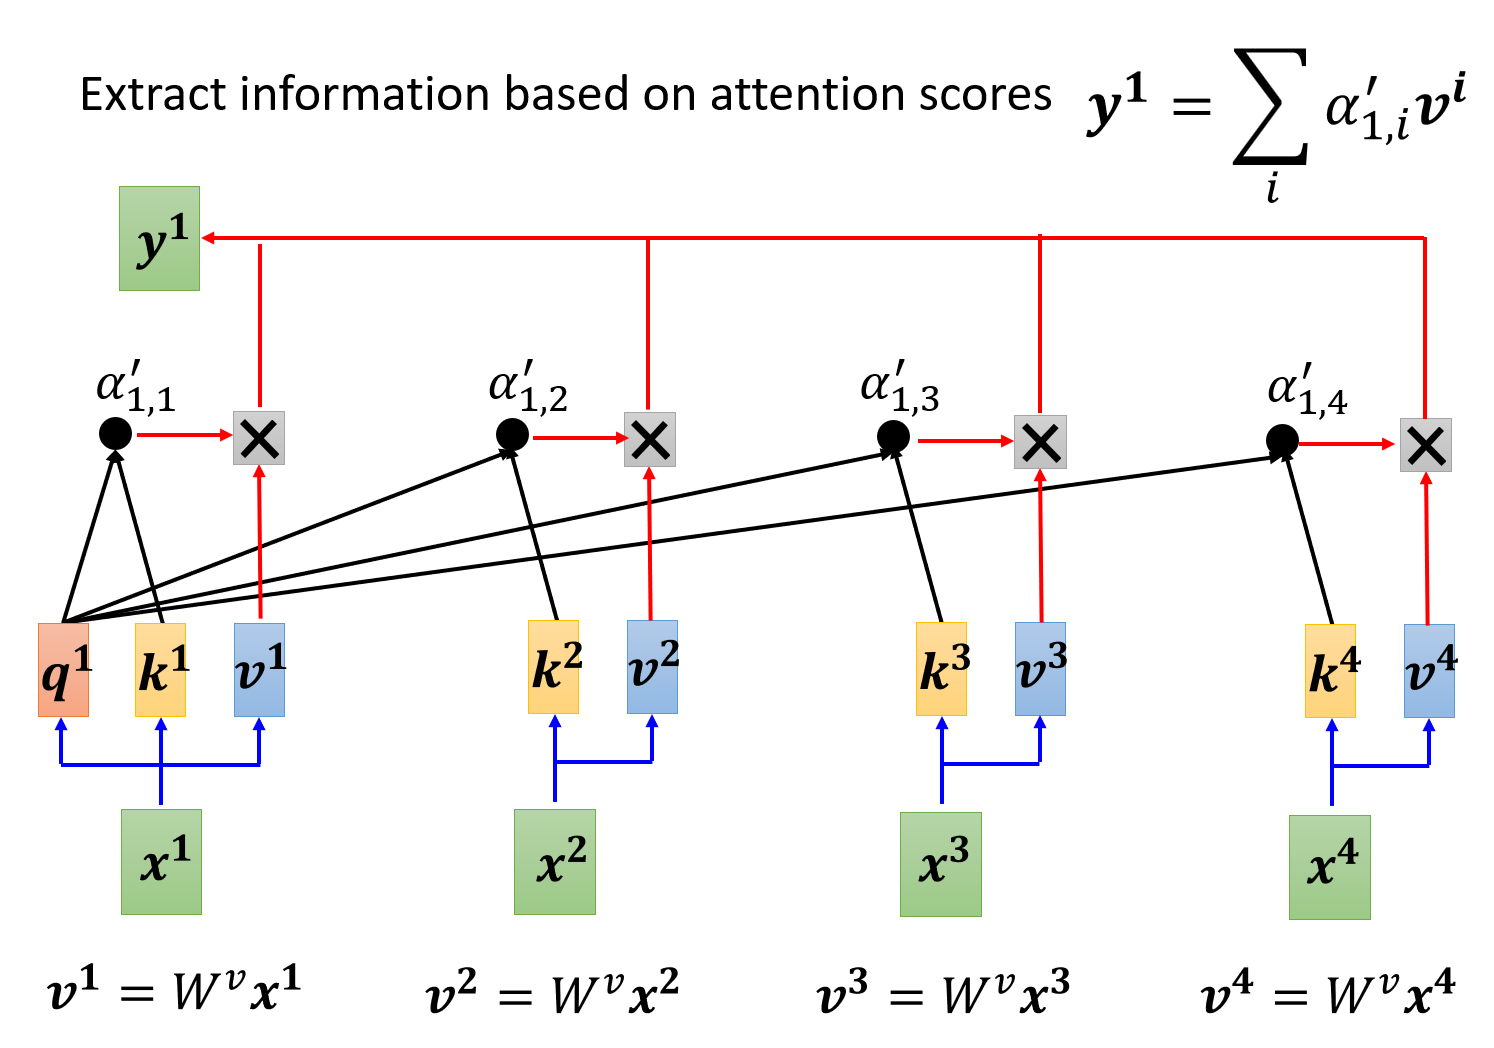
- 对于序列的每一个输入 , 我们还需引入一个线性层 (可学习的矩阵 ) 将输入序列映射到 .
- 接着我们就利用学习到的 attention score 对 value 进行加权平均, 即 .
- 最终我们得到了一个和输入序列同样长度的输出序列 .
7.2 Self-Attention 的并行计算
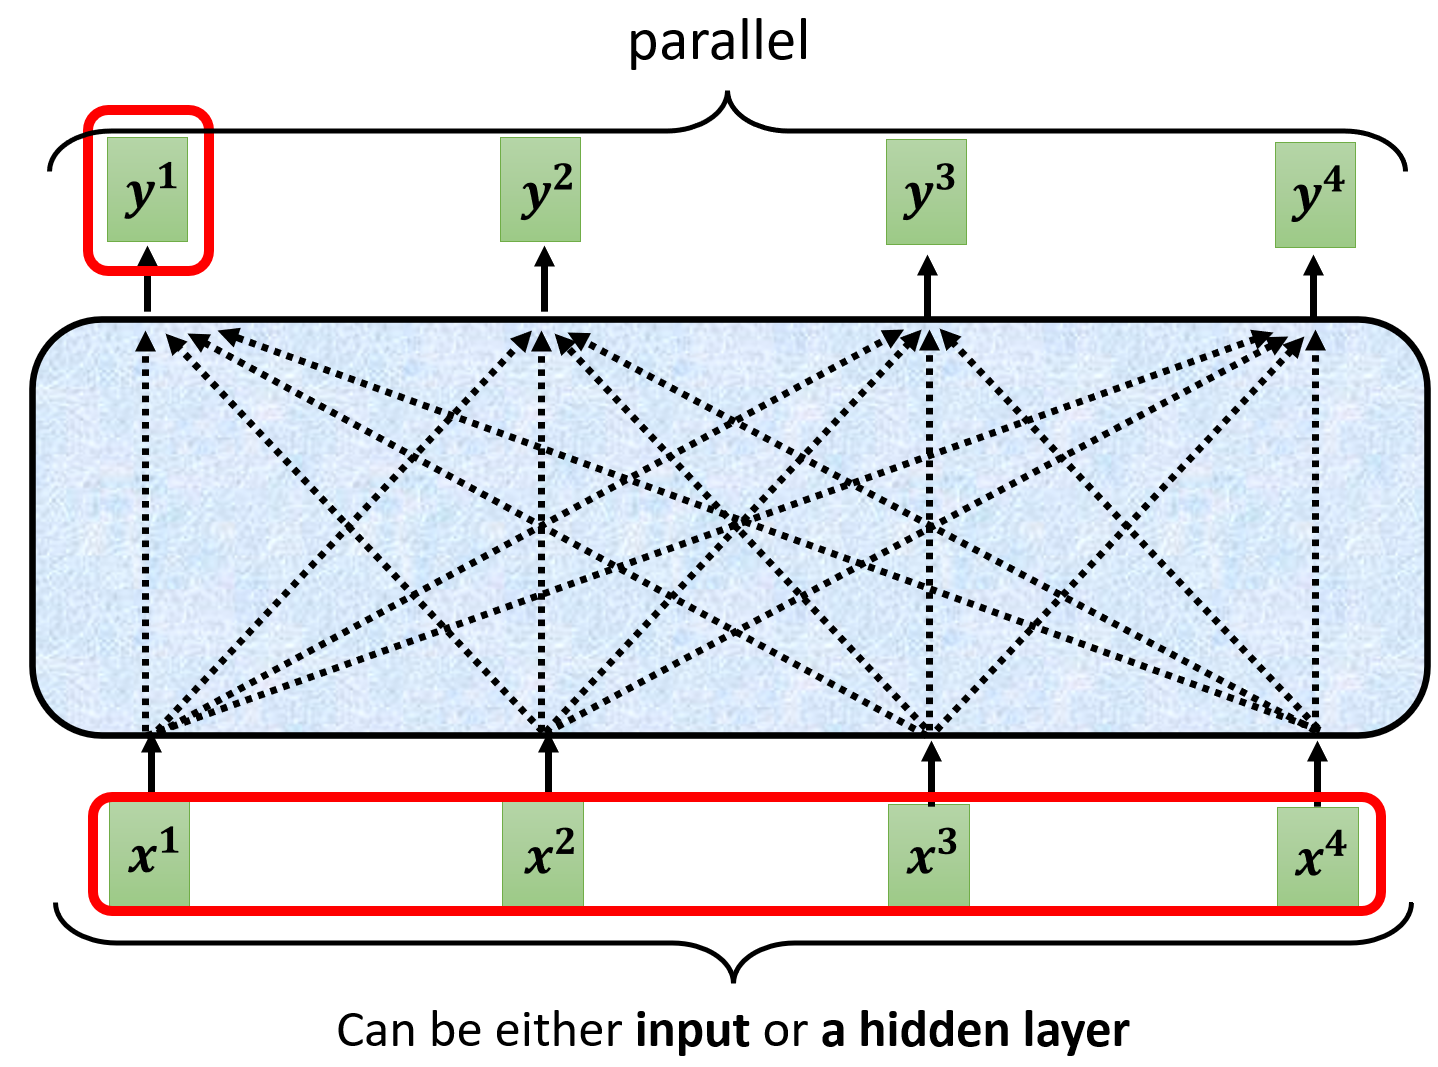
- 对于 Self-Attention 的计算, 我们输入一个序列 , 并且输出一个和输入序列同样长度的序列 的过程并不是依序一个一个产生的.
- 事实上, 我们可以并行地计算所有的 (即所有的输出), 即一次性产生所有的输出. 这是因为每一个输出 都只依赖于输入序列 的 Q, K, V, 运算, 而后一个输出 的计算并不依赖于前一个输出 的计算. 这使得 self-attention 可以利用 GPU 的并行计算能力, 从而提高计算效率.
我们可以通过矩阵重新表示 Self-Attention 的计算过程以理解并行计算.
- 首先生成 矩阵:
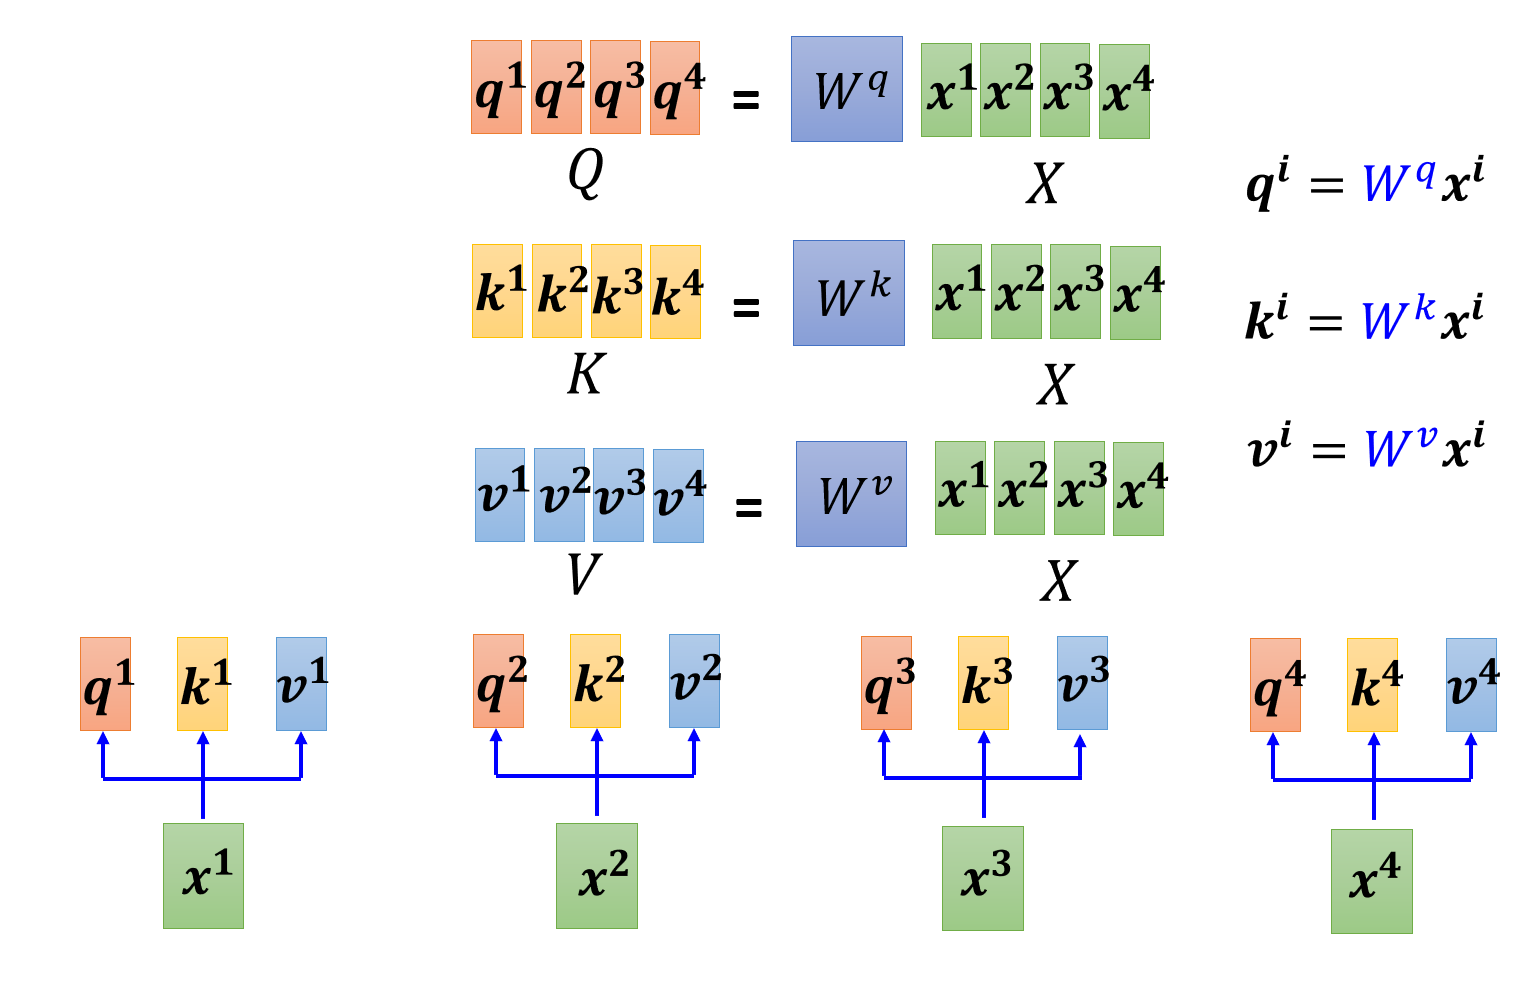
- 对于输入序列 , 我们可以将其整合为一个矩阵 .
- 正常我们需要分别对于每一个位置的输入 分别乘以一个可学习的矩阵 , 从而得到 . 如果把每一个这样的操作拼接起来, 就得到:
- 接着根据 矩阵计算 attention score:
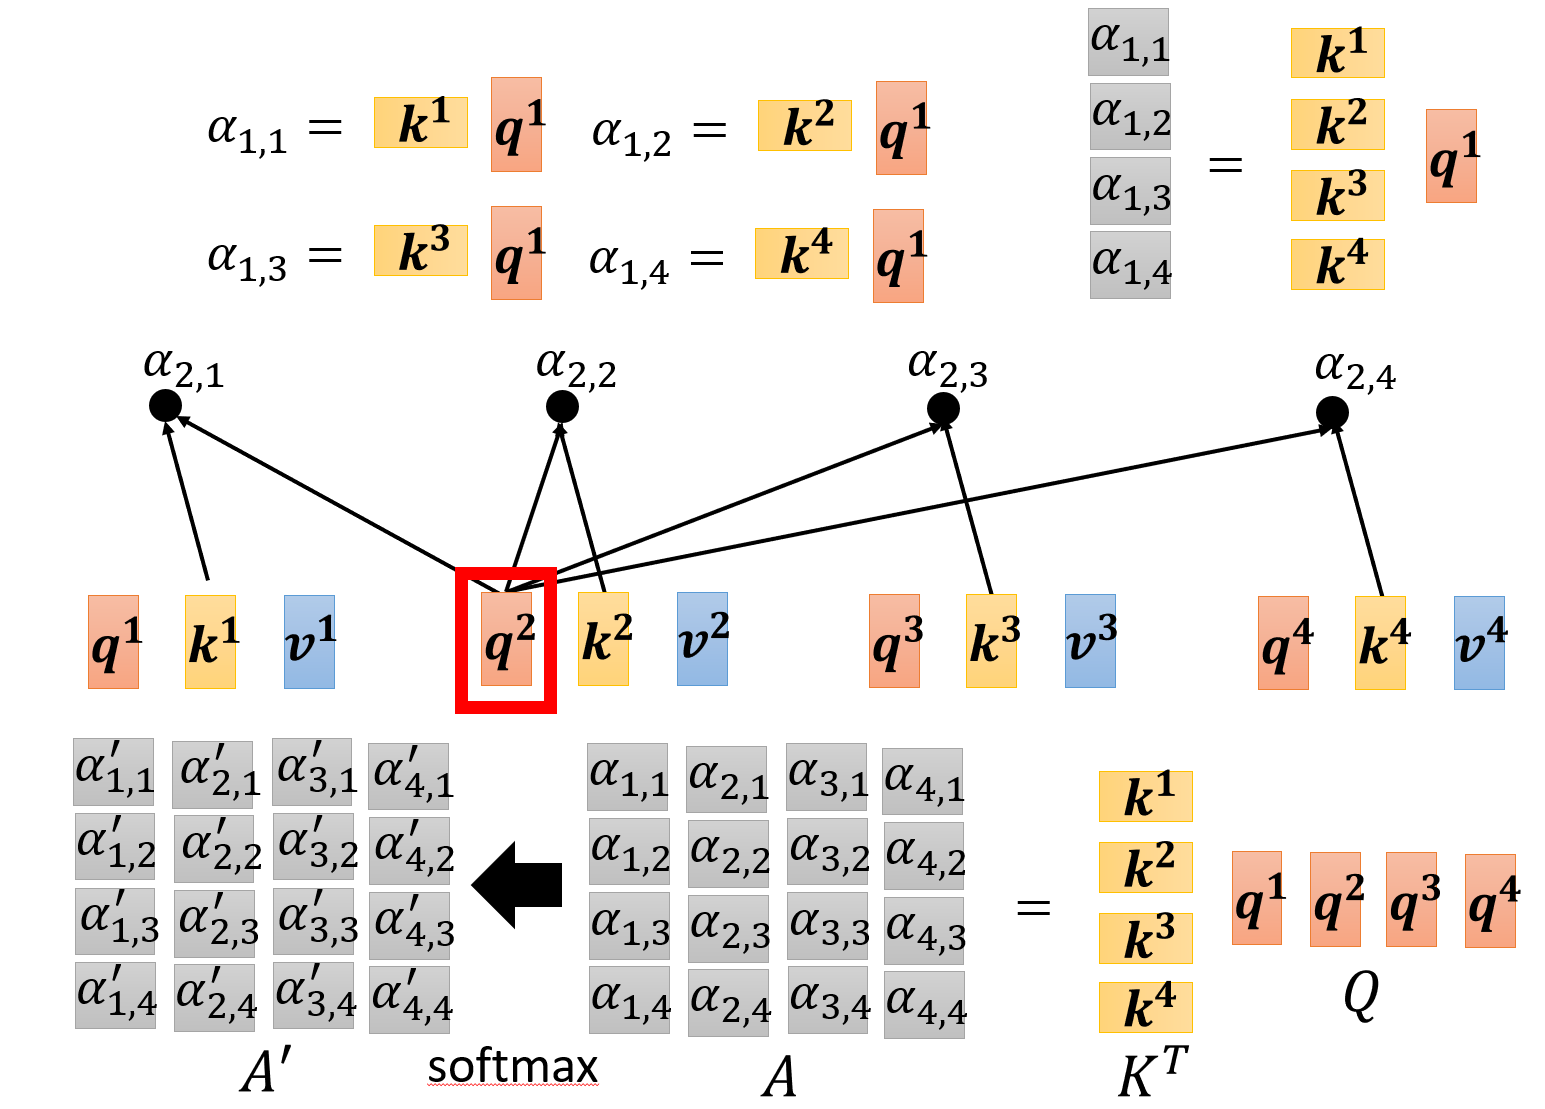
- 对于每一个 query , 我们需要计算其和所有的 key 之间的相似度. 对于每一个 query , 我们要依次和所有的 key 进行计算相似度, 得到attention score . ( 是表示第 个 query 和第 个 key 之间的相似度). 若序列一共有 个元素, 则每个元素各自会作为一次 query, 并且和每个 key 进行计算相似度, 因此我们可以将所有的 通过矩阵乘法表示为:
- 之后我们可以通过 Softmax 函数对每一列进行归一化 (即对具有相同 query 的所有 key 进行归一化), 得到 .
- 别忘了这里还有一个除以 的操作, 以控制模型的 magnitude.
- 最终将得到的注意力矩阵 乘以 value 矩阵 :
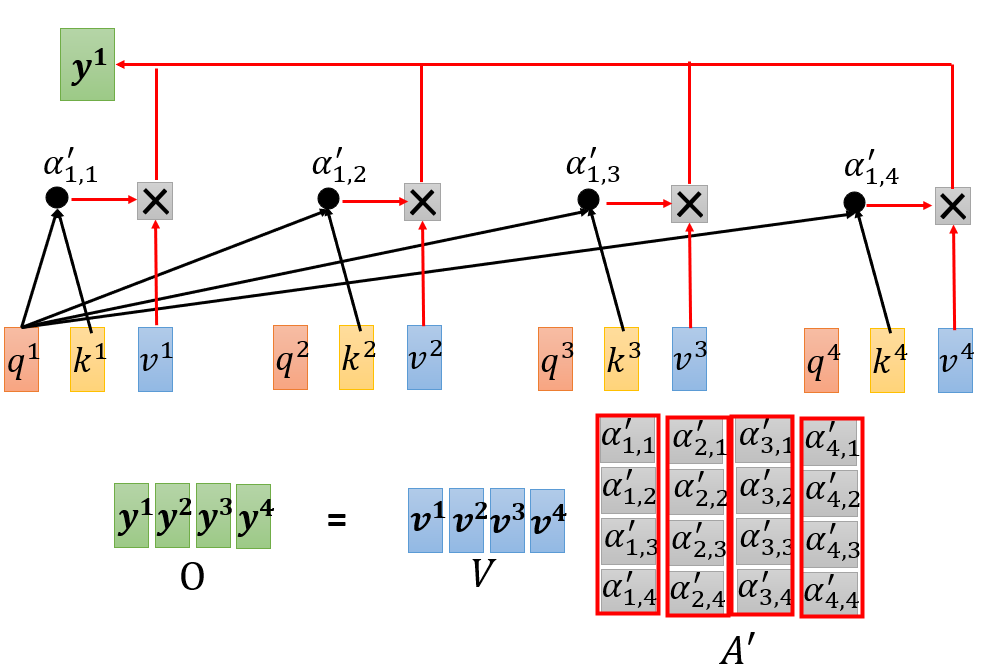
- 对于每一个 query , 我们需要根据得到的注意力矩阵 对 value 矩阵 进行加权平均, 即 . 通过矩阵乘法可以表示为:
因此总结一下, 给定输入序列 , 我们可以通过以下的矩阵乘法计算得到输出序列 :
其中 是可学习的参数矩阵, 在神经网络中表现为一个全连接层. 这整合起来也就和最开始介绍注意力机制时提到的公式基本保持一致 (整体相差了一个转置, 并且在归一化的 Softmax 函数 中还应除以 ):
如果再进一步考虑多头注意力机制, 我们可以将上述的计算过程并行地进行 次, 并且将每一个 head 得到的输出拼接起来, 从而得到最终的输出. 在本质上, 相当于设置要学习 个不同的 , 得到 组 , 并且对每一组进行上述的计算得到输出 .
7.3 循环神经网络与 Self-Attention 的计算复杂度对比
首先补充两个概念.
- 对于两个矩阵 , 可以证明矩阵乘法 的计算复杂度为 .
- 在当前序列处理的语境中, 最大路径长度(maximum path length) 是指在信息传播过程中, 从序列的一个位置 到另一个位置 所需的最短操作步数的最大值.
- 最短操作步数是为了避免故意折返等”绕路”操作
- 该最短操作步数的最大值反映了序列的信息从一个位置传播到另一个位置的传播效率.
假设需要处理一个长度为 的序列 , 其中 .
对于一个循环神经网络 (RNN), 假设隐藏层的维度也为 , 则对于每一个时间步, 我们都需要进行如下计算:
其中 , . 因此一步计算的复杂度为 . 对于整个序列, 我们需要顺序的计算 次, 因此整个序列的计算复杂度为 . 另一方面由于 RNN 严格的序列性质, 每一个时刻的输出都完全依赖于前一个时刻的输出, 因此必须逐步计算, 从而最大路径长度为 .

对于 Self-Attention, 其一个基本的计算过程为:
其中 , , 是可学习的参数矩阵.
- 计算 的复杂度为 , 同理. 故得到 的总复杂度为 .
- 计算 的复杂度为
- 计算 的复杂度为
故总的计算复杂度当 时主导项为 . 另一方面, 对于最大路径长度, 由于 Self-Attention 的并行计算特性, 其在一次计算中就会同时综合所有的输入并按照”注意力”进行加权, 因此最大路径长度为 .
综上所述, 自注意力机制在信息传播上的效率要远高于循环神经网络, 因此其能够很好的兼顾长距离依赖关系和计算效率. 不过另一方面, 其计算复杂度为 , 而循环神经网络的计算复杂度为 , 因此在序列长度 较大时, Self-Attention 的总计算量(FLOPs)会更大, 但由于其可并行计算, 实际的墙钟运行速度通常仍快于必须顺序执行的 RNN.
8. Positional Encoding
目前的注意力机制并不能捕捉到序列中的位置信息或者前后顺序关系. 为了解决这个问题, 我们可以引入 Positional Encoding. 我们需要手动的为每一个 token 添加一个位置编码, 使得模型能够区分不同的位置.
记输入为 , 其中 为序列长度, 为特征数. 我们可以为每一个位置 添加一个位置编码 , 并且将其加到原始的输入中. 我们可以记位置编码的矩阵为 , 则最终的加入位置编码的输入为:
一个常用的位置编码如下, 对于序列的每一个位置 , 注意到 依然是一个 维的向量含有不同的特征. 我们可以将其按照特征的奇偶位置分为两部分, 并且对每一部分分别进行编码:
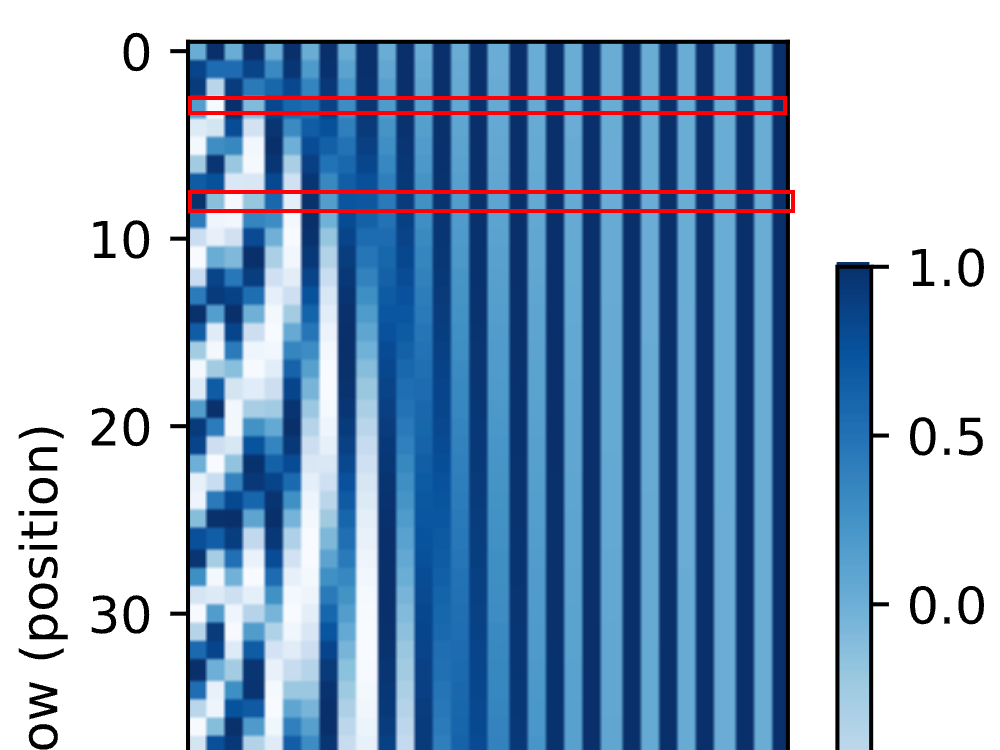
仔细观察这个位置编码 , 其每一行表示了一个时间步(一个位置) 的 position encoding, 而每一列表示了一个特征的 position encoding. 下图是一个 position encoding 的矩阵的可视化结果. Heatmap 中每一个像素就表示了矩阵中的一个元素, 而颜色表示了元素的大小. Heatmap 的行列顺序与矩阵的行列顺序一致.
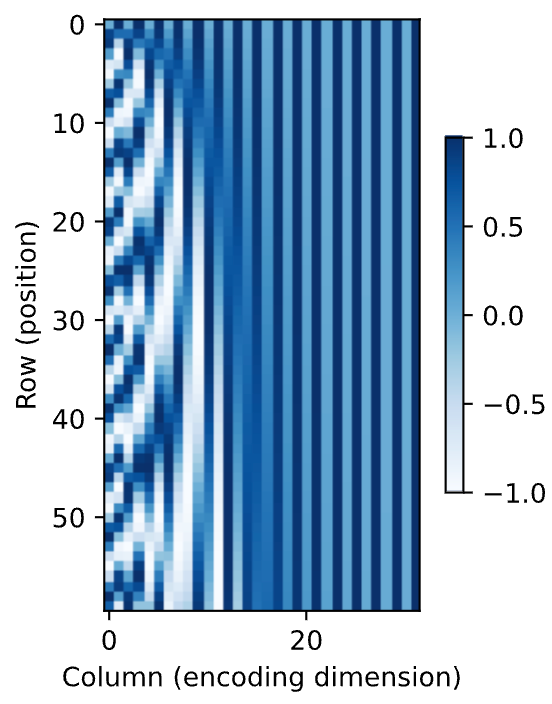
下图给出了一个position encoding 矩阵 在 时的函数图像. 纵轴为 position encoding 的值, 横轴为时间步 (即position).
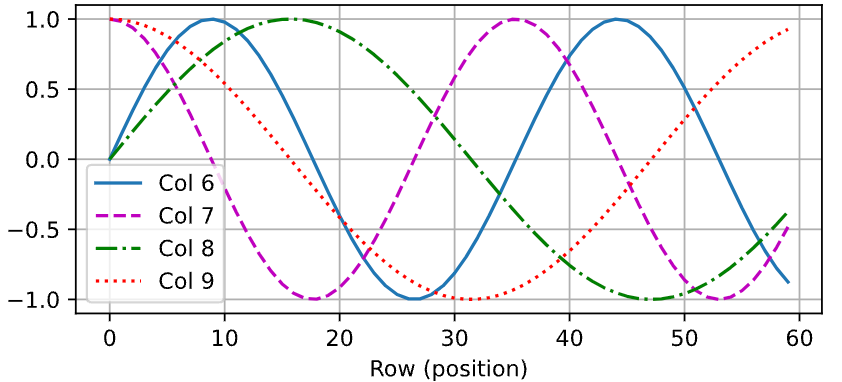
我们发现, 随着维度 dimension 的增加, 位置编码的频率会降低, 也就是其变化的速度会变慢. 某种意义上这和二进制编码的思想有些类似. 就像1~10的二进制编码为: 0001, 0010, 0011, 0100, 0101, 0110, 0111, 1000, 1001, 1010. 第一位的变化频率最快, 第二位的变化频率次之, 以此类推. 因此如下图所示, 每一行(也就是每个时间步/每个pos) 的每个特征维度通过不同的频率进行编码, 从而生成了一个类似于条形码一样的东西, 并且由于 的不同, 这保证了每一个位置的编码都是唯一的. 然而该编码方式又明显的优于二进制编码, 因为其每一个位置的编码表示都是之间的实数, 而不是二进制的0/1.
这种编码频率随着特征维度的增加而降低的思想也和绝对位置编码(absolute position encoding) 有关. 该思想的核心是, 通过不同的频率编码, 使得每一个位置的编码都是唯一的, 并且通过不同的频率, 使得模型能够更好地区分不同的位置.
9. Transformer: Attention is All You Need
Transformer 是 Vaswani 等人在 2017 年提出的一个基于 self-attention 机制的模型, 用于解决 Sequence-to-Sequence 任务. 其模型结构如下. 整体而言, Transformer 会分为左右 Encoder 和 Decoder 两大部分. 浅显的说, Encoder 用于将输入序列编码为一个和输入同样长度的隐藏表示序列, 而 Decoder 用于将该序列解码为输出序列.

9.1 Encoder in Transformer
我们首先从 Encoder 开始. 最直观地说, Encoder 的任务是给定一个输入序列 且每一个输入本身也可以是一个向量表示 (), Encoder 会将其编码为一个同样长度的序列 ().
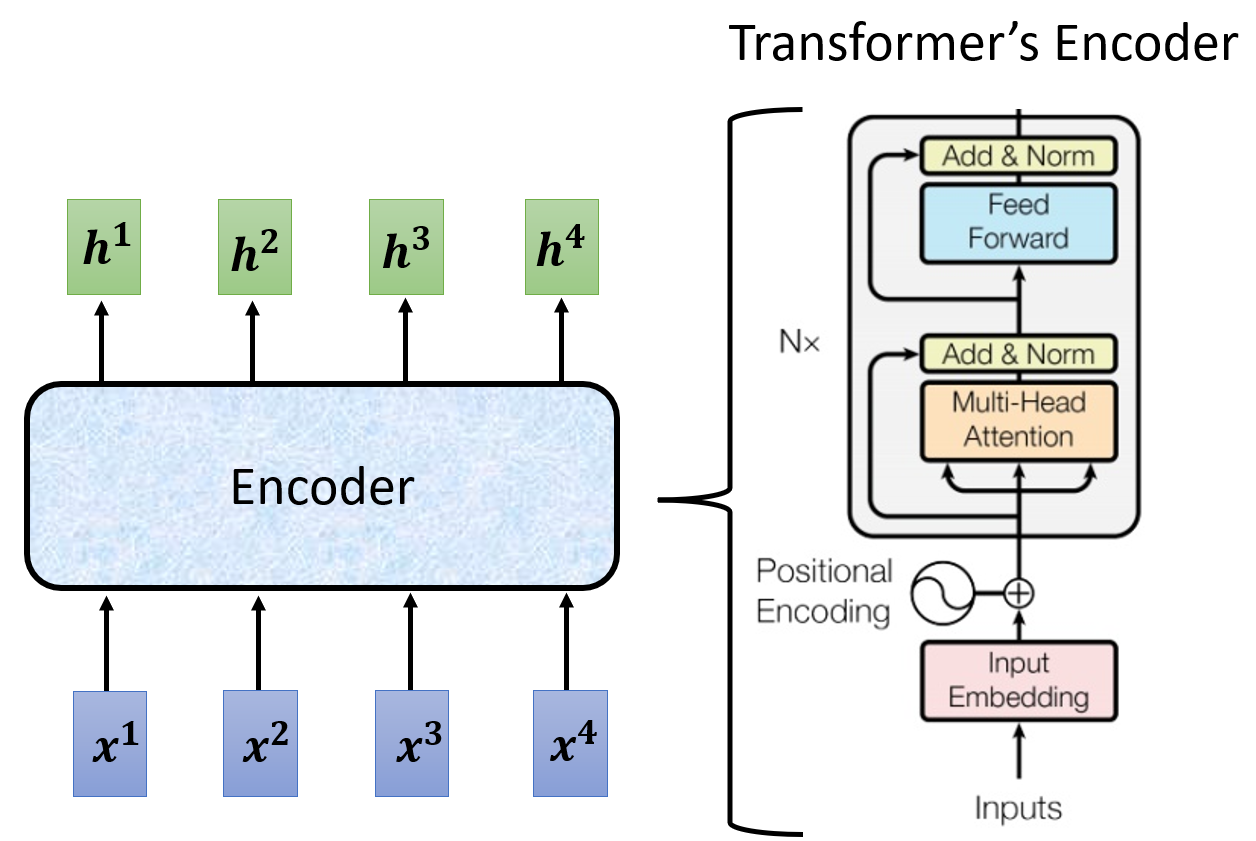
具体而言, 原始序列在经过初始的 Embedding 层 (即通过一个线性层等将输入映射到更高维的空间) 和 Positional Encoding 层 (即为每一个位置添加位置编码) 进行初步处理后, 会经过 个 Encoder Layer. 每一个 Encoder Layer 中主要会有下面几个重要的组成部分: Multi-head (Self-)Attention, Add & Norm (Residual Connection & Layer Normalization) 以及 Positionwise FFN (Feed-Forward Network).
9.1.1 Add & Norm 中的 Residual Connection
事实上 Add & Norm 的模块包含了两个步骤的操作: Residual Connection 和 Layer Normalization. Residual Connection 是在深度学习中非常常用也非常重要的一个技巧. 给定一个输入 以及神经网络的一层 且 (即 的输出和输入的维度相同), Residual Connection 的操作就是将输入和输出相加, . 这样的操作会使得信息能够更好地传递, 并且能够更好地训练深度神经网络.
这在 Transformer 的结构图中体现为将某层的输入添加一个支路, 绕过该层的操作, 直接连接到该层输出的 Add & Norm 处. 其中的 Add 就是 的加法操作.
9.1.2 Add & Norm 中的 Layer Normalization
这里的 Norm 指的是 Layer Normalization. LN 指的是对于每一个样本, 将其自己本身的每个特征进行归一化. 具体而言, 给定一个输入 , Layer Normalization 的操作为:
Layer Normalization 更关注的是每一个 token () 中的特征的分布结构. 这样的操作可以使得每一个 token 的特征分布更加稳定, 从而更好地训练深度神经网络. 而 Batch Normalization (即对每一个特征对所有样本进行归一化) 对于 Transformer 这种序列模型而言, 其输入的序列长短并不是固定的, 因此这种跨样本的归一化并不适用.
9.1.3 Positionwise FFN
Positionwise FFN 其实就是一个前馈神经网络的全连接层. 这里之所以强调 Positionwise, 是因为这个全连接层是对每一个位置的特征进行独立的全连接操作. 具体而言, 给定一个输入 , Positionwise FFN 的操作为:
对于每一个时间步都是单独进行全连接操作, 不同时间步之间的数据并不会有交互. 这也体现了深度学习中的解耦(Decoupling)思想. 不过这里的 FFN 的参数是共享的, 也就是对所有的时间步的输入的全连接处理方式是一样的.
具体而言, 这个 Positionwise FFN 在 Transformer 中被定义为一个两层的全连接神经网络:
且同样保证输入和输出的维度相同.
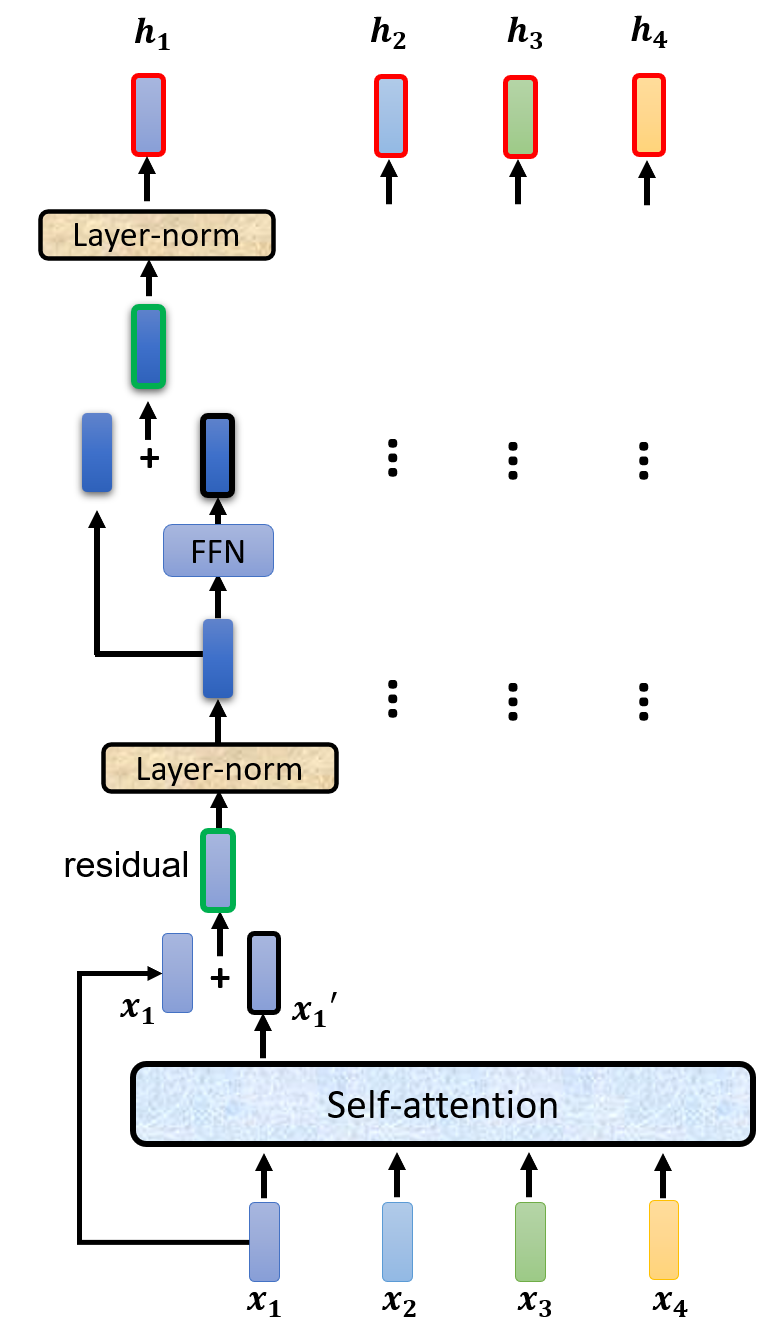
因此最终总结一下输入序列 经过 Encoder 得到的输出序列 的计算过程为:
- Embedding 层映射到更高维空间:
- 加入 Positional Encoding 引入位置信息:
- 通过 次 Encoder Layer 进行处理. 对于每一个 Encoder Layer:
- 先通过 Multi-head (Self-)Attention: 将数据分为 个 head, 并且对每一个 head 进行 Self-Attention 操作, 得到 . 最终将所有的 head 的输出拼接起来, 映射回原始的维度, 得到 . 这一步统一记为 .
- 再 Add & Norm: 先进行 Residual Connection, 即将通过 Multi-head Attention 得到的 和原始的输入 相加, 得到 . 然后进行 Layer Normalization, 对于 的每一列(即每一个时间步的所有特征)进行归一化, 得到
- 再 Positionwise FFN: 对于 进行 Positionwise FFN 操作. 即对于每一个时间步的特征进行独立的全连接操作:
- 再次 Add & Norm: 对于 进行 Residual Connection 和 Layer Normalization, 得到最终的输出 . 并且这个 会进入下一次的 Encoder Layer 进行同样的操作.
9.2 Decoder in Transformer
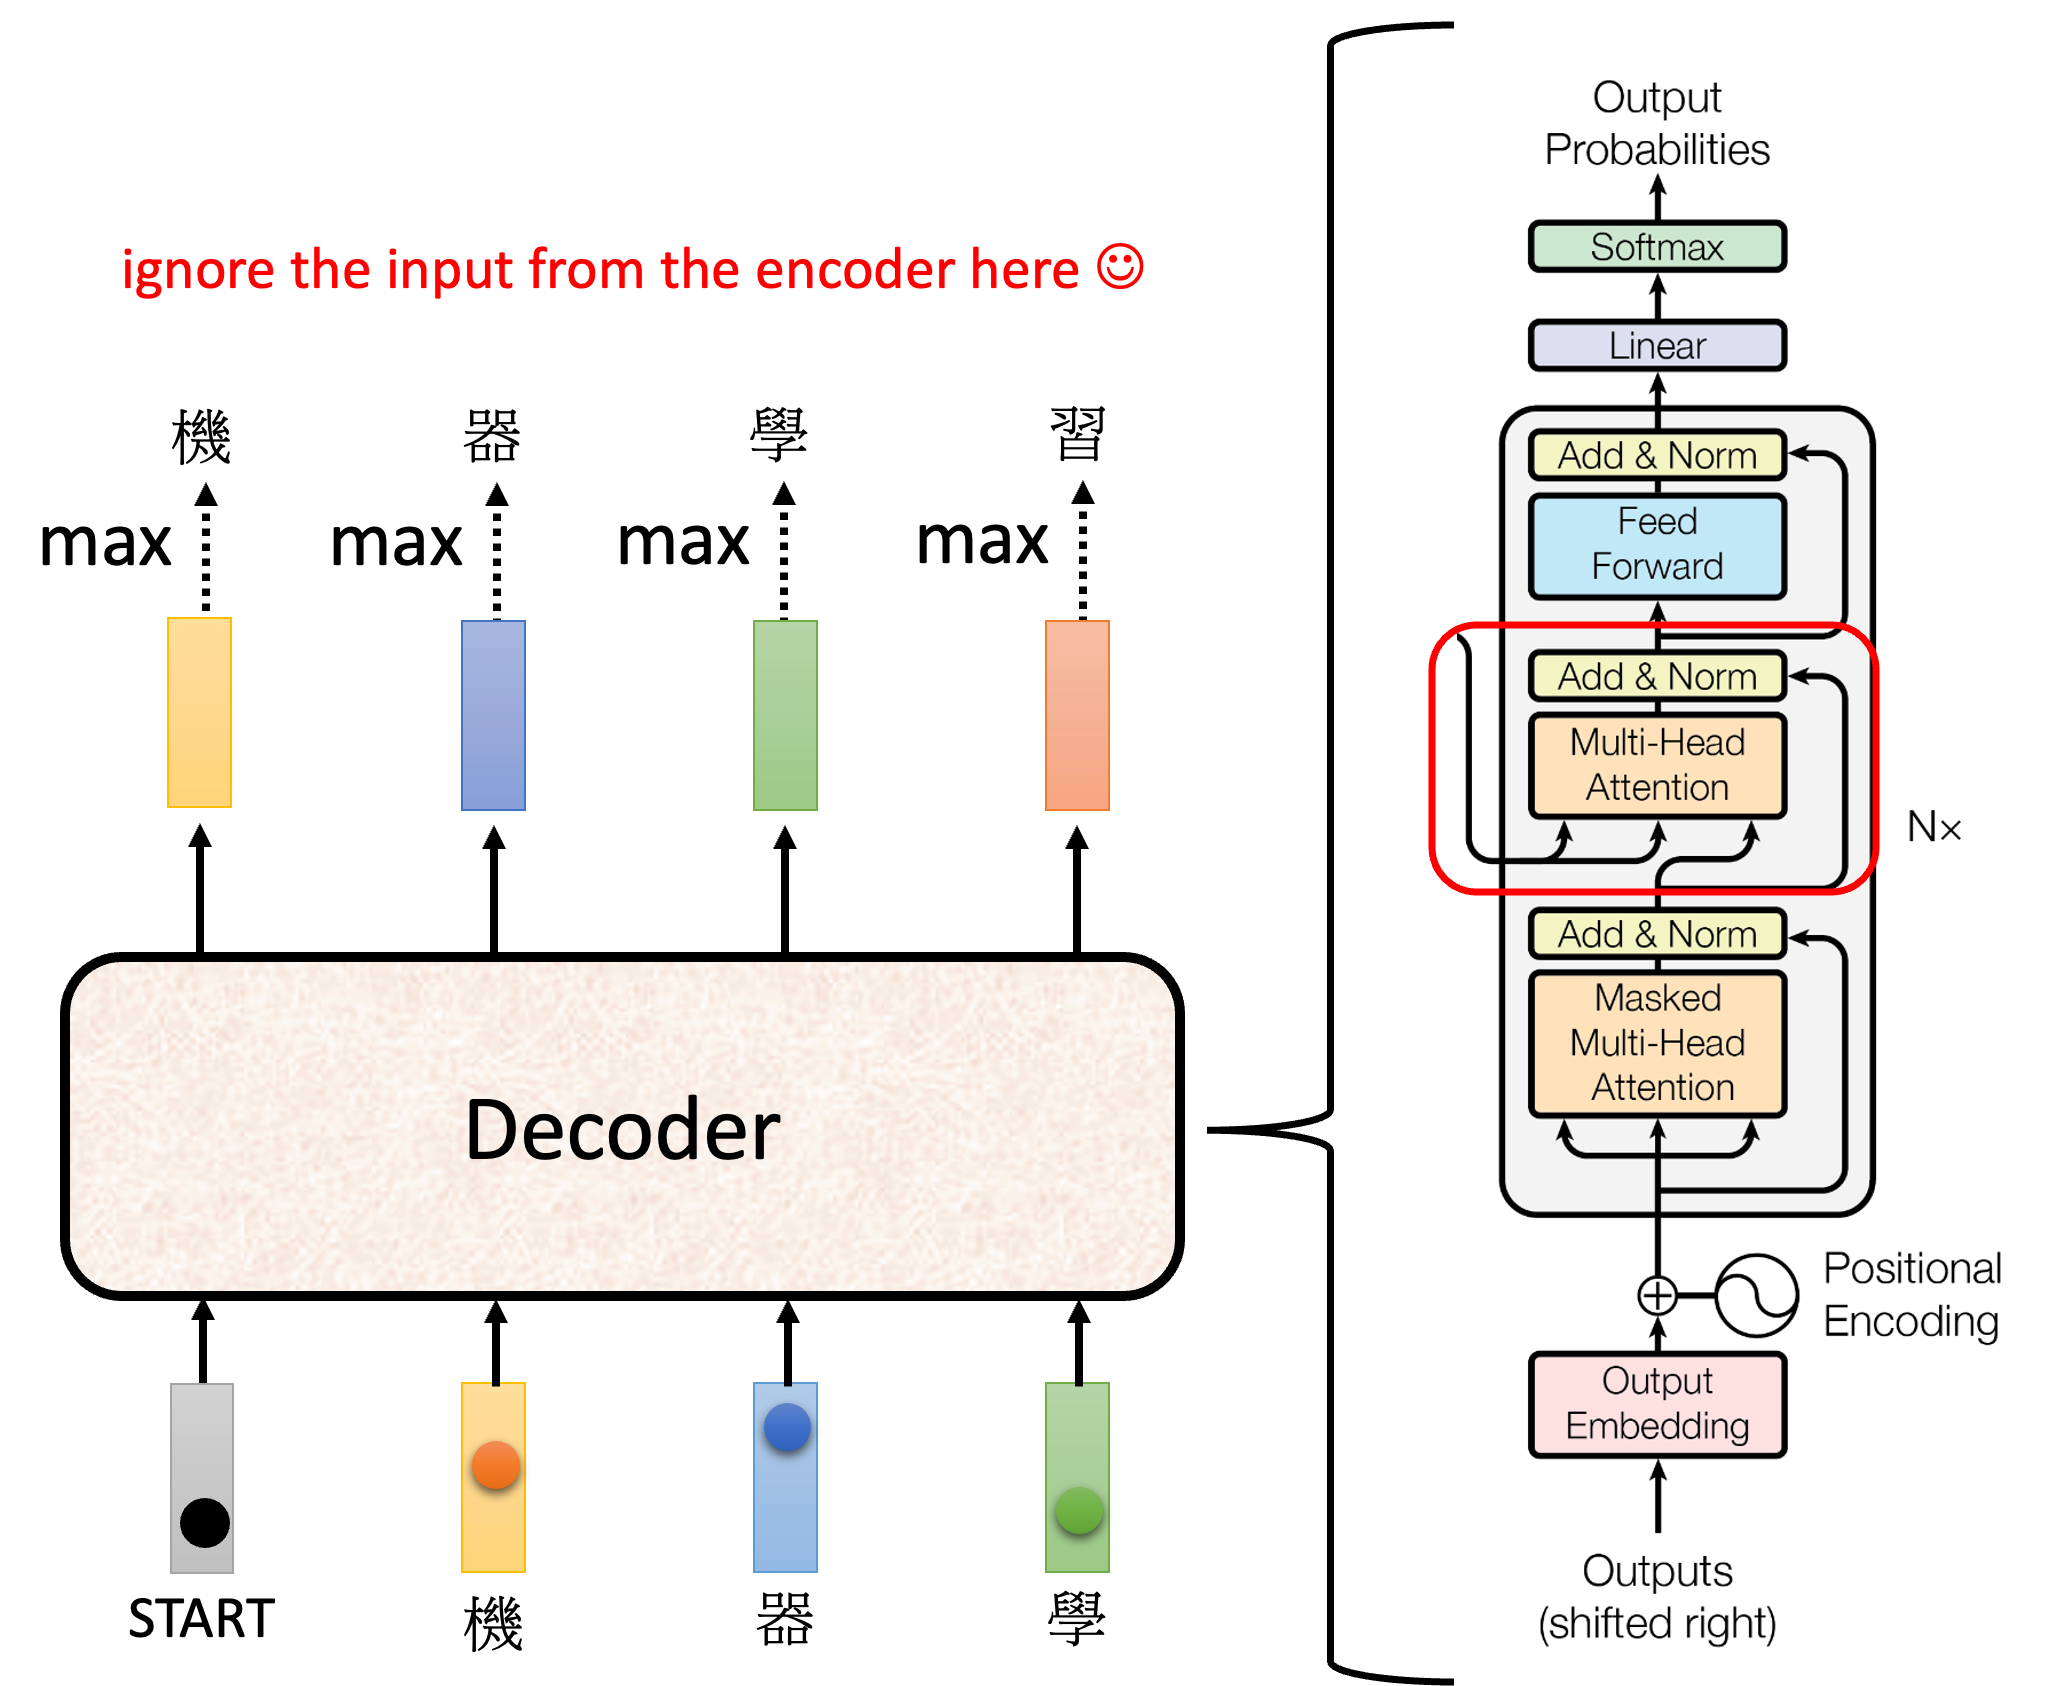
Transformer 模型架构图中右侧的部分就是 Decoder. Decoder 整体要做的事情是将 Encoder 的输出序列进行解码, 从而得到最终的输出序列. Decoder 的结构和 Encoder 类似, 但可以看到 Decoder 的 Attention 模块有两个: 一个是 Masked Multi-head Attention, 其输入是从下方的 Output Embedding 和 Positional Encoding 得到的; 另一个是 Multi-head Attention, 其输入是从左侧的 Encoder 得到的. 稍后将详细介绍之类的具体结构. 但总的而言, 其依旧是将不同来源的序列信息利用 Attention 机制进行整合, 并且通过 Positionwise FFN 进行特征提取 (并整体 Decoder 结构重复次), 最终得到输出序列.
9.2.1 Seq2Seq 任务与 Auto-regressive Decoder
由于 Decoder 的输出 (的最常见的应用) 是具体的 Seq2Seq 任务的生成序列, 因此这里沿用李宏毅老师的例子, 以语音辨识的任务为例介绍 Decoder 的结构. 具体而言, 对于该任务, Encoder 和之前的环节是负责将语音信号分割为一个个的音素, 并以向量表示为一个 token 序列. 经过了 Encoder 的处理后可以学习到一些特征. 而 Decoder 的任务就是将这些特征解码为对应的文字序列.
整体上看, Decoder 的结构和 Encoder 类似, Decoder 输出的序列长度由生成过程中何时产生 <EOS> 决定, 并不需要和 Encoder 的输入/输出序列长度一致. 其进行的操作也与 Encoder 大体相似, 利用 Attention 的机制继续对序列的信息进行整合学习. 因此直到最后学习到的特征表示会最后通过一个 Linear 层和 Softmax 层, 将序列中每个位置学习到的 token 的高维向量进行分类, 从而得到对于每个位置可能的 token (如文字) 的概率分布. 进而进一步通过 或者依据概率进行采样, 从而得到最终的输出序列. (这也是原图中 Output Probabilities 的含义)
Decoder 中, 根据其序列的生成模式不同会分为 Auto-regressive Decoder 和 Non-Auto-regressive Decoder. 其中前者更为常见. 简要而言其和 RNN 等的生成模式类似, 即最终序列的 token 都是一步一步生成的, 并且类似词语接龙一样, 下一个 token 的生成也会依赖于前面生成的 token, 即为其 auto-regressive 的特性. 具体而言:
- 我们一般会给 Decoder 的输入序列添加一个特殊的 token, 例如
<BOS>(Begin of Sentence), 作为 Decoder 的输入序列的第一个 token . - 然后 Decoder 会根据这个 token 生成下一个预测的 token .
- 再将这个预测的 token 作为下一个时间步的输入: .
- 以此类推, 直到预测下一个token应该是另一个特殊的 token
<EOS>(End of Sentence), 表示生成序列的结束.
9.2.2 Masked Multi-head Attention
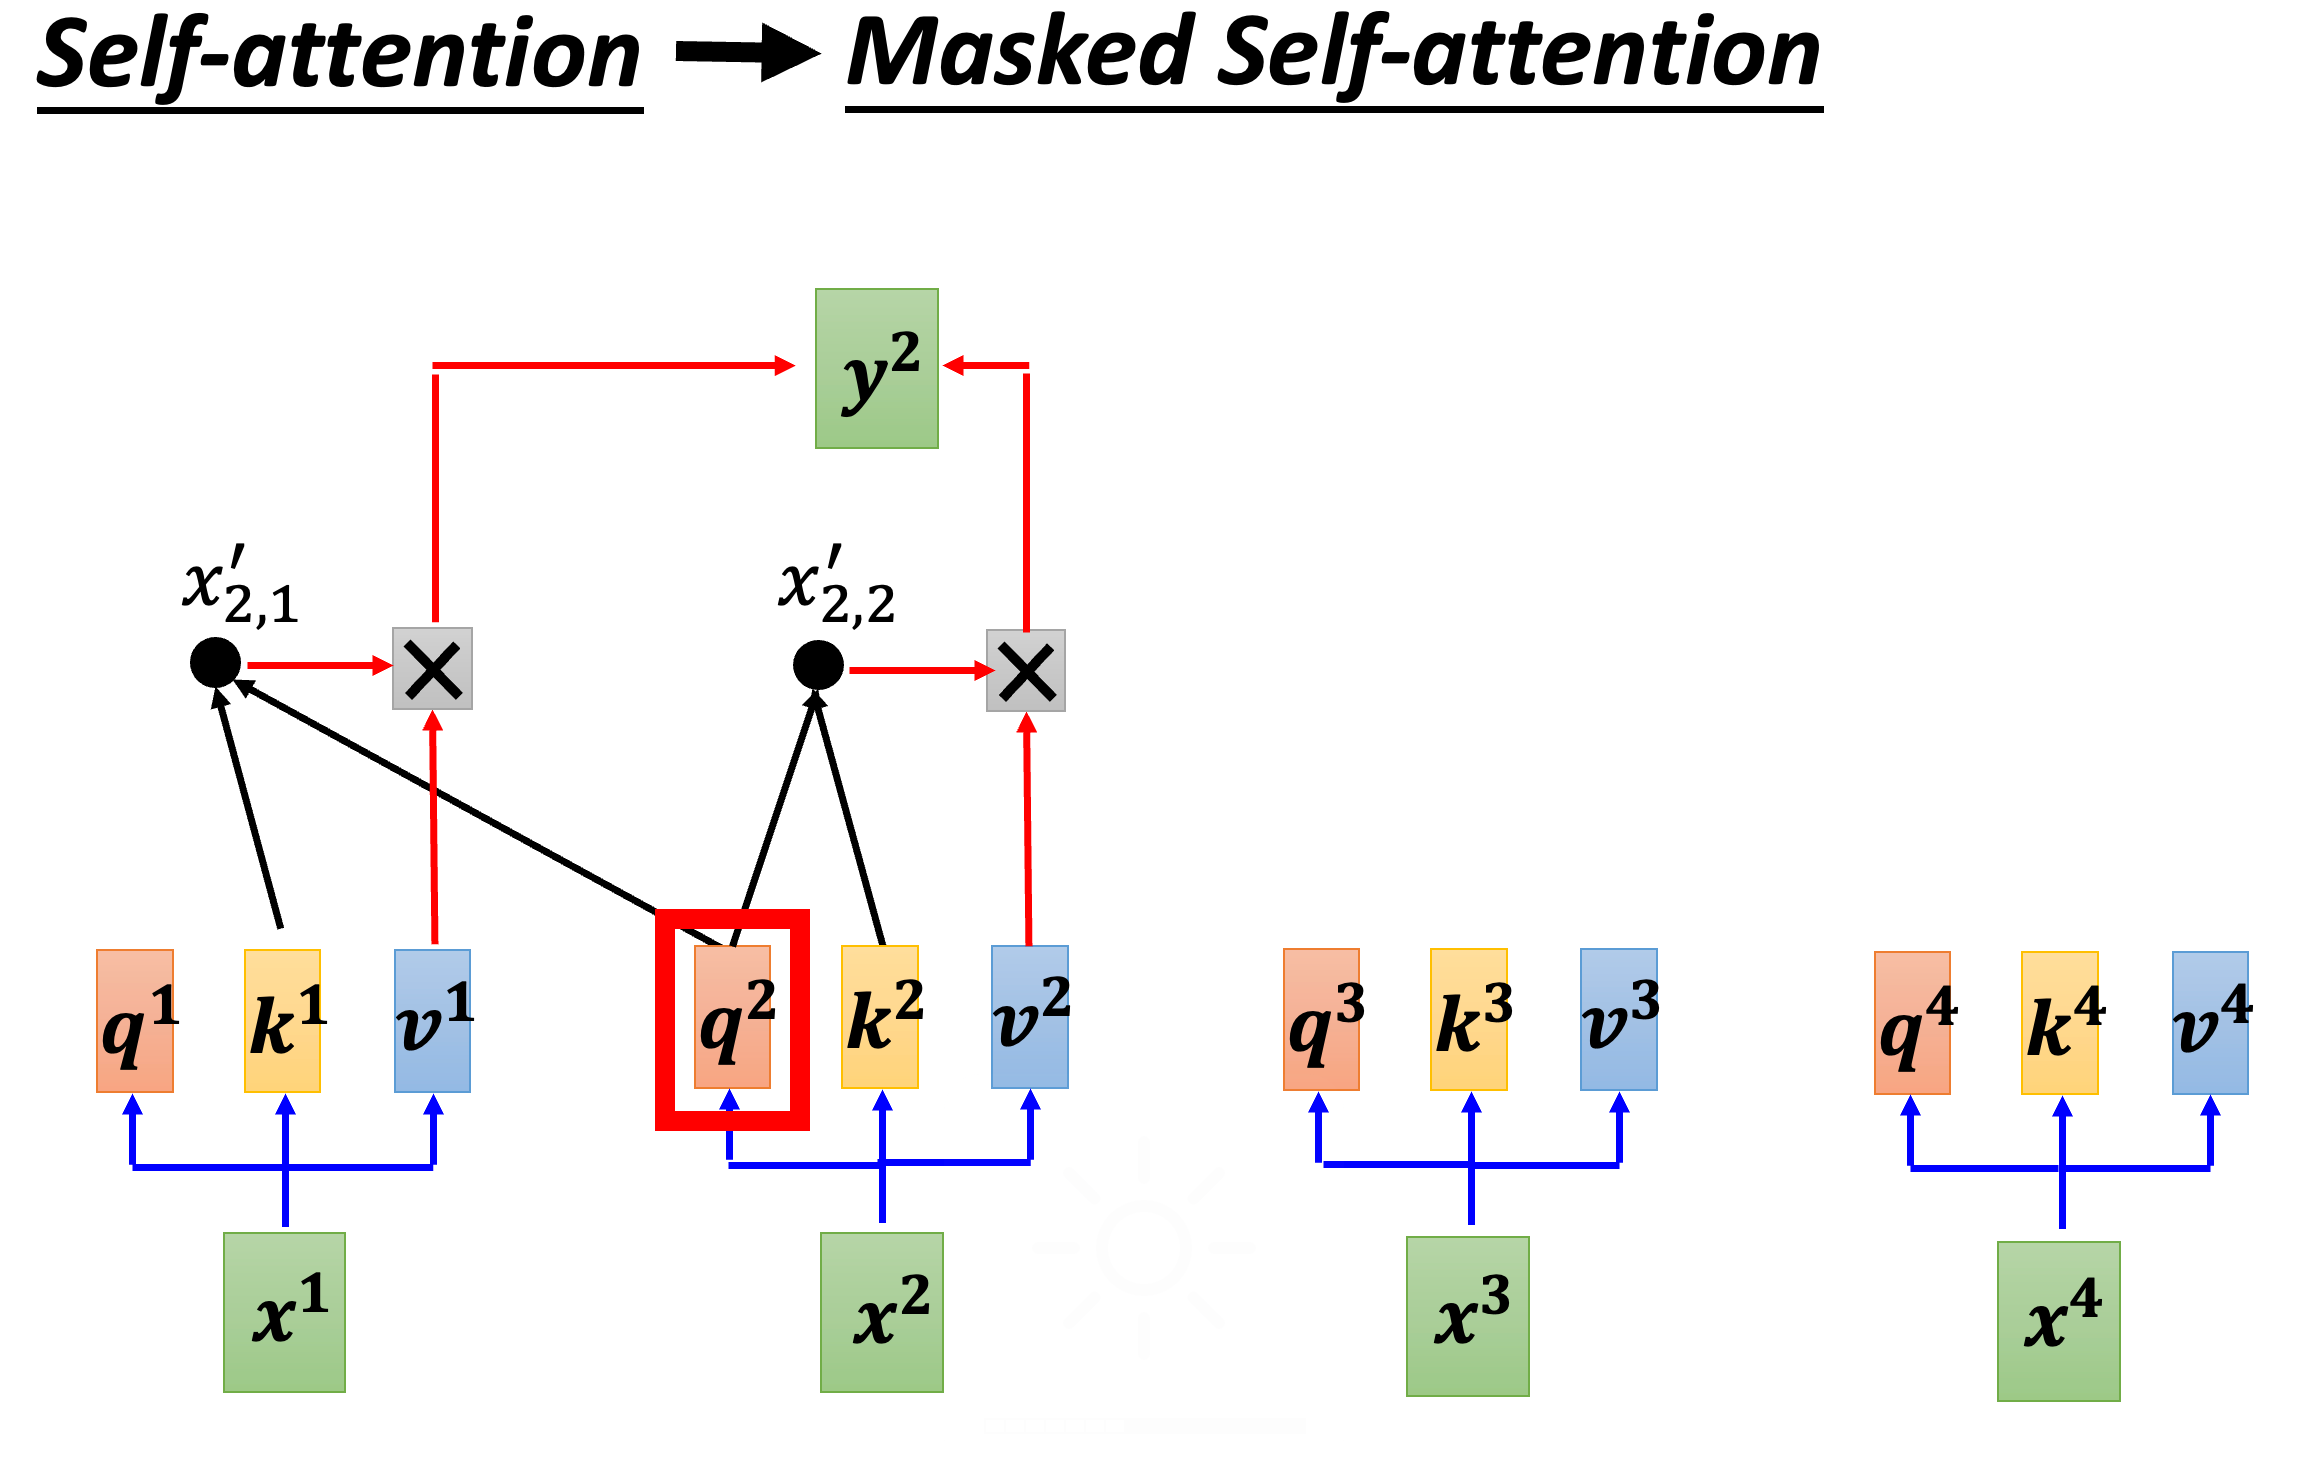
在 Decoder 中, 由于其生成序列的特性, 我们在生成序列的过程中是不能看到未来的信息的 (即要满足因果性, causality).
- 因此在 Decoder 中的 Self-Attention 操作中, 当我们想要生成第 个 token 时, 我们只能利用前面生成的 token , 但不能利用后面的 token .
- 具体而言, 例如当我们当前要生成 时, 我们只会用到 对 的注意力, 而不会用到 的信息.
在数学上, Masked Attention 的操作为:
其中 是一个 mask 矩阵, 其规则为
即
这样的操作就保证了在 Self-Attention 的计算中, 当我们计算 对 的注意力时, 只会用到 的信息, 也就是只会用到前面的信息, 而不会用到后面的信息 (因为后面的信息会被加上一个 的 mask, 使得经过 Softmax 后的值为0).
9.2.3 Output (Shifted Right)
尽管前文指出, Decoder 是按照 auto-regressive 的方式生成序列的, 但 Transformer 的一大优势就是并行化的序列处理. 因此在实作中, 我们并不能真正的等待上一个 token 生成后再生成下一个 token. 因此这里会采用 Output (Shifted Right) 的方式 (即原图右下角 Decoder 的输入的位置).
具体而言, 假设在训练的时候我们原始的目标序列是 Y = [<BOS>, "I", "am", "Transformer", <EOS>], 其中 <BOS> 和 <EOS> 分别表示开始和结束的特殊 token. 那么 Decoder 的输入序列就会是 Y_input = [<BOS>, "I", "am", "Transformer"], 而 Decoder 的输出目标(label) 序列就会是 Y_target = ["I", "am", "Transformer", <EOS>]. 这样就保证了, 当给定 Y_input 的输入 <BOS> 时, Decoder 会训练期望生成 Y_target 中的 token “I”; 而当给定输入 “I” 时, Decoder 会训练期望生成下一个 token “am”, 以此类推.
这里还需要进一步结合 Masked Attention 的机制. 二者综合, 就会保证 Decoder 实际上的训练过程类似于:
- 输入
<BOS>, <MASKED>, <MASKED>, <MASKED>→ 目标输出"I" - 输入
<BOS>, "I", <MASKED>, <MASKED>→ 目标输出"am" - 输入
<BOS>, "I", "am", <MASKED>→ 目标输出"Transformer" - 输入
<BOS>, "I", "am", "Transformer"→ 目标输出<EOS>
也就是通过并行的方式实现了类似于 RNN 的 auto-regressive 的生成模式.
9.2.4 Cross-Attention in Decoder
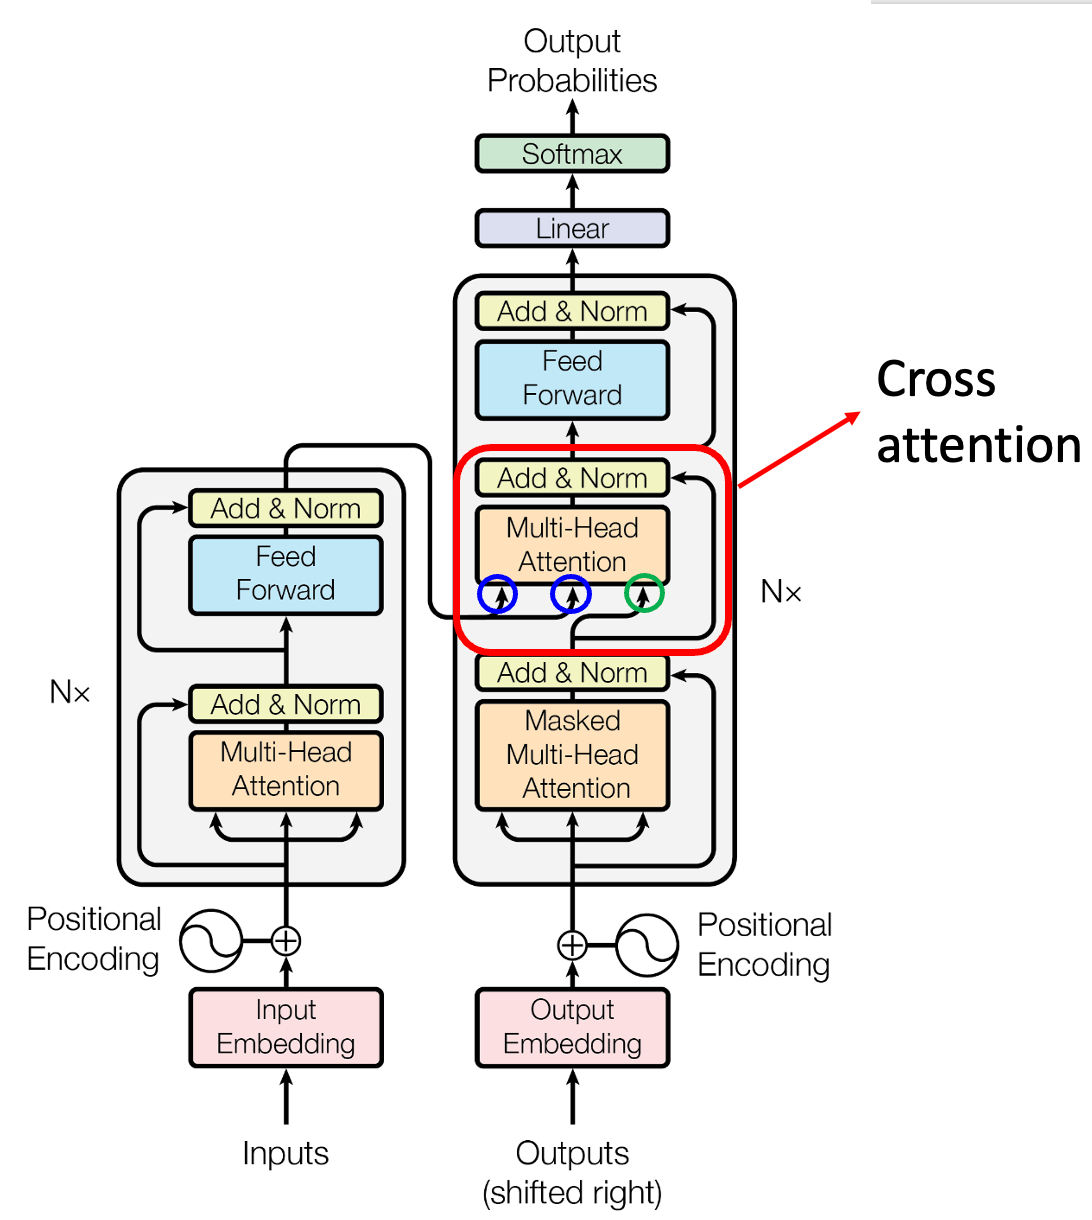
最后一个与 Encoder 不同的地方就是 Decoder 中的 Cross-Attention 操作 (即上图中的红色部分). 该部分实现了 Decoder 和 Encoder 之间的信息交互.
若注意观察, 可以发现从 Encoder 中共有两个箭头流向 Decoder 的这个 Cross-Attention 模块, 而还有一个箭头是从 Decoder 的下方经过 Masked Multi-head Attention 模块流向 Decoder 的 Cross-Attention 模块. 这三个箭头事实上就代表了 Attention 机制的三个输入: Query, Key 和 Value. 因此 Decoder 的 Cross-Attention 整体计算过程都和 Encoder 的 Multi-head Attention 类似, 只是其 Key 和 Value 来自于 Encoder 的输出序列, 而 Query 来自于 Decoder 的输出序列.
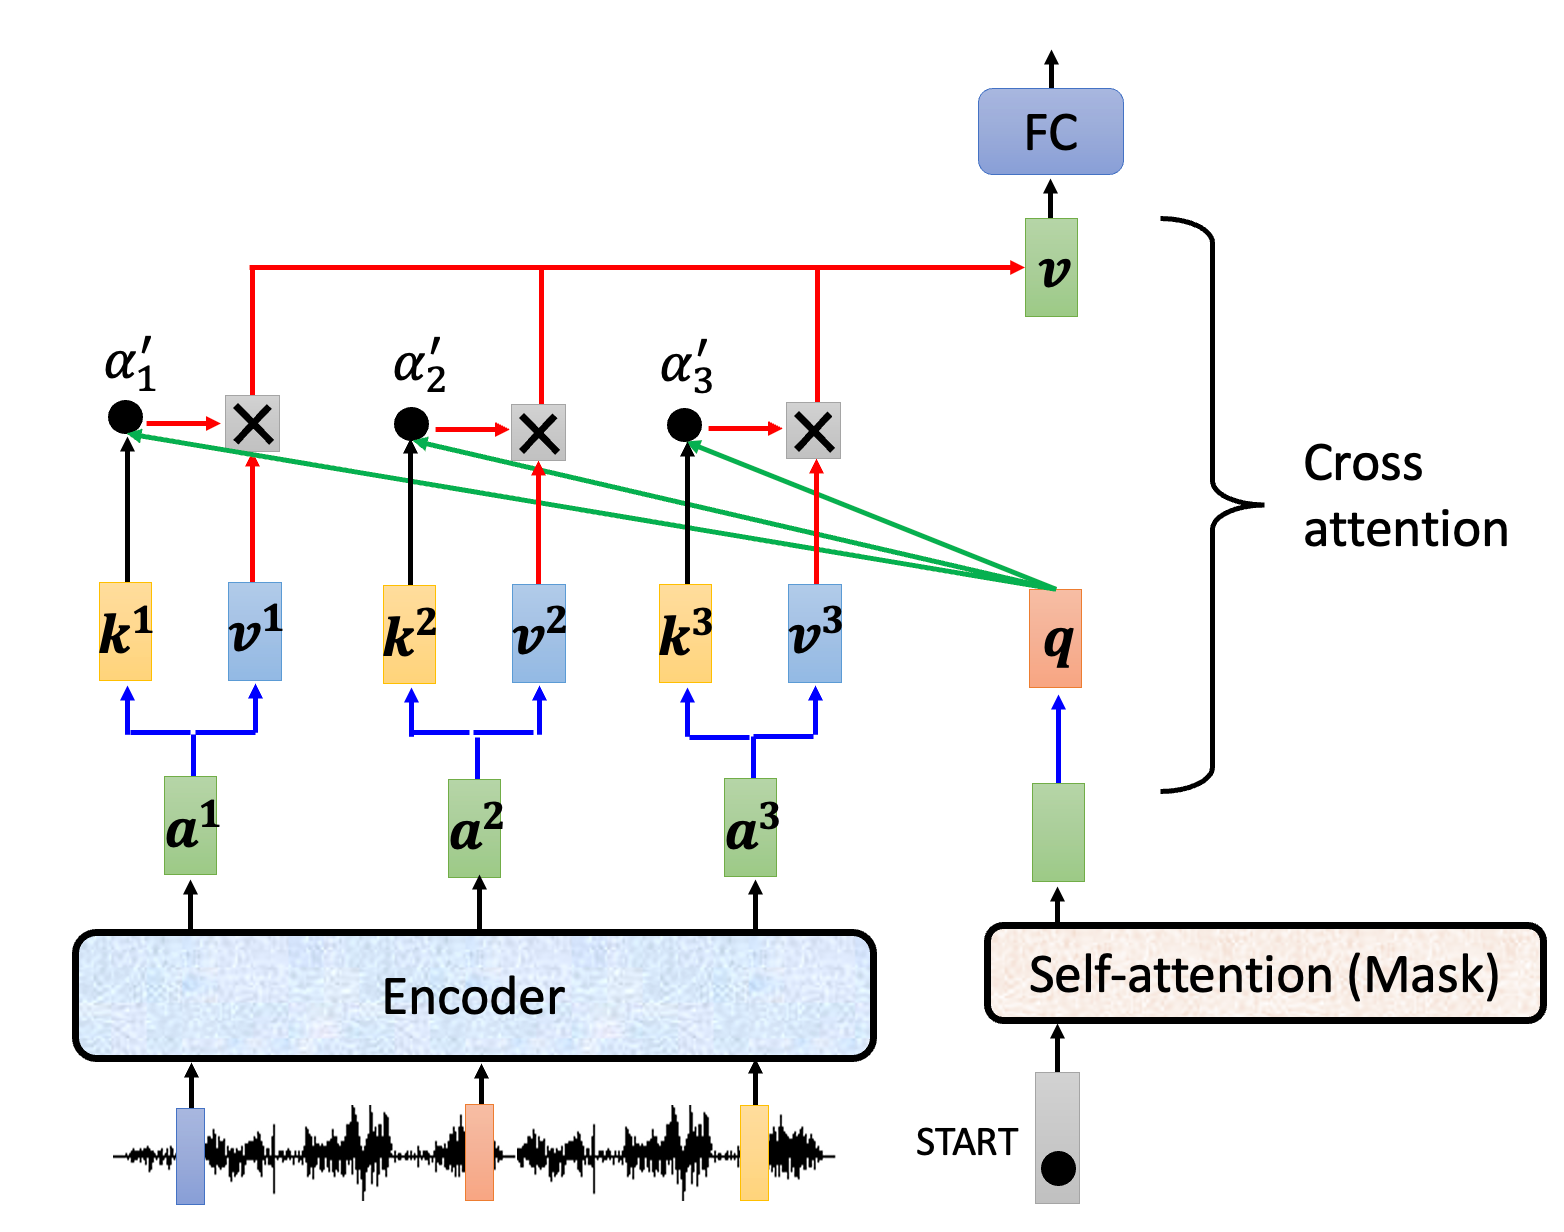
- 每次 Decoder 会从下方的 Masked Multi-head Attention 学到一个输入 token 的特征表示.
- 接着, 这个 token 的特征表示就会变成一个 Query , 与 Encoder 的输出序列 (即我们对于原始输入序列进行了一系列的 Encoding 处理后学习到的信息) 进行 Cross-Attention 操作.
这样的操作还是很符合直觉的. 类似于, 我们要根据输入的序列信息生成一个输出序列, 那么我们在生成每一个 token 时, 都会根据目前的输出序列信息作为 Query, 依次对照输入序列的信息 Key 关于 Value 进行整合, 从而生成下一个 token.