References
- Reading: Dive into Deep Learning (D2L), Modern Recurrent Neural Networks
回顾, 对于 Sequential 数据, 我们会维护一个隐藏状态 来存储过去的信息, 通过
的形式来更新隐藏状态.
1. Long Short-Term Memory (LSTM) Networks
RNN 在长序列上, 由于其梯度会层层累加, 造成 gradient explosion 或 gradient vanishing 问题. 因此我们需要一些更复杂的结构来维护长时间的依赖关系. LSTM 通过引入 Gate 来控制信息的流动, 使得信息可以在 cell state 中长期存储, 有效地解决了 Vanishing gradient 问题.
1.1 LSTM Cell
在 LSTM 中, 我们会维护一个 cell state 来对信息进行长期存储. 在其中, 我们会使用三个 Gate 来控制信息的流动:
- Input Gate : 控制当前输入 进入 cell state 的程度.
- Forget Gate : 控制 cell state 中的信息被遗忘 (趋近于 0) 的程度.
- Output Gate : 控制 cell state 中的信息被输出的程度.
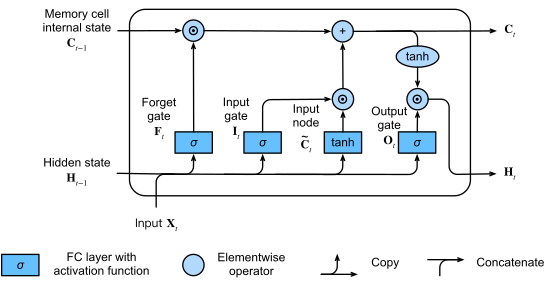
下面给出具体的公式:
假设当前的 batch size 为 , 输入维度为 , 隐藏状态维度为 . 假设输入为 , 隐藏状态为 . 则在 时刻, LSTM 的计算过程为:
- 其中, , 类似一个 soft-switch, 控制信息的流动. 取 1 时表示完全通过, 取 0 时表示完全不通过.
- Internal state 表示了 LSTM 的最核心更新规则: 我们会将历史的信息 进行一定程度的遗忘 , 然后将当前输入的信息 进行一定程度的保留 , 最后将两者相加.
最终这个 cell state 会通过一个输出 gate 来控制输出:
在 PyTorch 中, LSTM 已经被实现为一个内置的模块, 我们可以直接使用:
class LSTM(nn.Module):
    def __init__(self, input_size, hidden_size, num_layers=1):
        super(LSTM, self).__init__()
        self.lstm = nn.LSTM(input_size, hidden_size, num_layers)

    def forward(self, x):
        out, _ = self.lstm(x)
        return out
2. Gated Recurrent Unit (GRU)
GRU 是一个更简化的 LSTM 变种, 它将 input gate 和 forget gate 合并成一个 update gate , 通过一个 reset gate 来控制 cell state 的更新.
在 时刻, GRU 的计算过程为:
- 当 Reset gate 趋近于 1 时, , 使得当前的 hidden state 退化为: , 也就是 GRU 退化为一个普通的 RNN.
- 当 Reset gate 趋近于 0 时, 当前的 hidden state 会被重置为 0, 使得模型能够忘记之前的信息, 模型退化为 , 即一个普通的 MLP.
最终我们通过 update gate 来控制当前的 hidden state 的最终输出:
- 当 趋近于 1 时, , 使得当前的 hidden state 保持不变.
- 当 趋近于 0 时, , 使得当前的 hidden state 被重置为 .
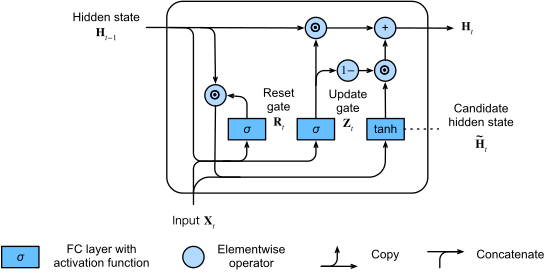
在 PyTorch 中, GRU 已经被实现为一个内置的模块, 我们可以直接使用:
class GRU(nn.Module):
    def __init__(self, input_size, hidden_size, num_layers=1):
        super(GRU, self).__init__()
        self.gru = nn.GRU(input_size, hidden_size, num_layers)

    def forward(self, x):
        out, _ = self.gru(x)
        return out
LSTM v.s. GRU
- GRU 的模型设计更为简洁, 一般而言其训练速度更快
- 然而由于没有 LSTM 中的 internal state, 在一些具有非常强的长时间依赖关系的任务上, GRU 的性能可能会稍差一些.
3. Deep RNNs
这里的 Deep RNNs 指的是在 RNN 的序列基础上, 我们把每一步的处理模块也换成一个更深层的处理网络. 一个一般的具有 层的长度为 的 RNN 的结构图如下:
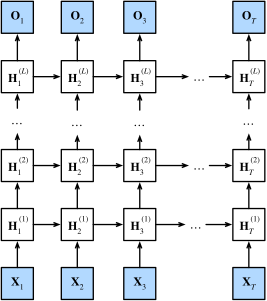
可以看到, 这里的每一个 Hidden State (e.g. ) 都有两个输入: 同一时间步的上一层输入 (e.g. ) 和上一时间步的当前层输入 (e.g. ). 这样就形成了一个深度的 RNN 结构. 因此可以抽象为如下数学公式:
- 其中 , , , .
- 一般而言 , .
4. Bi-directional RNNs
Bi-directional RNNs 是在 RNN 的基础上, 将输入序列同时从前向和后向进行处理. 这样可以使得模型在每一个时间步都能获得前后文的信息. 这尤其在一些 NLP 任务中 (例如 Speech Detection, Missing Token Prediction 等) 非常有用, 我们常常需要前后文的信息来进行判断.
例如:
- I am _.
- I am _ hungry.
- I am _ hungry and I can eat half a cow.
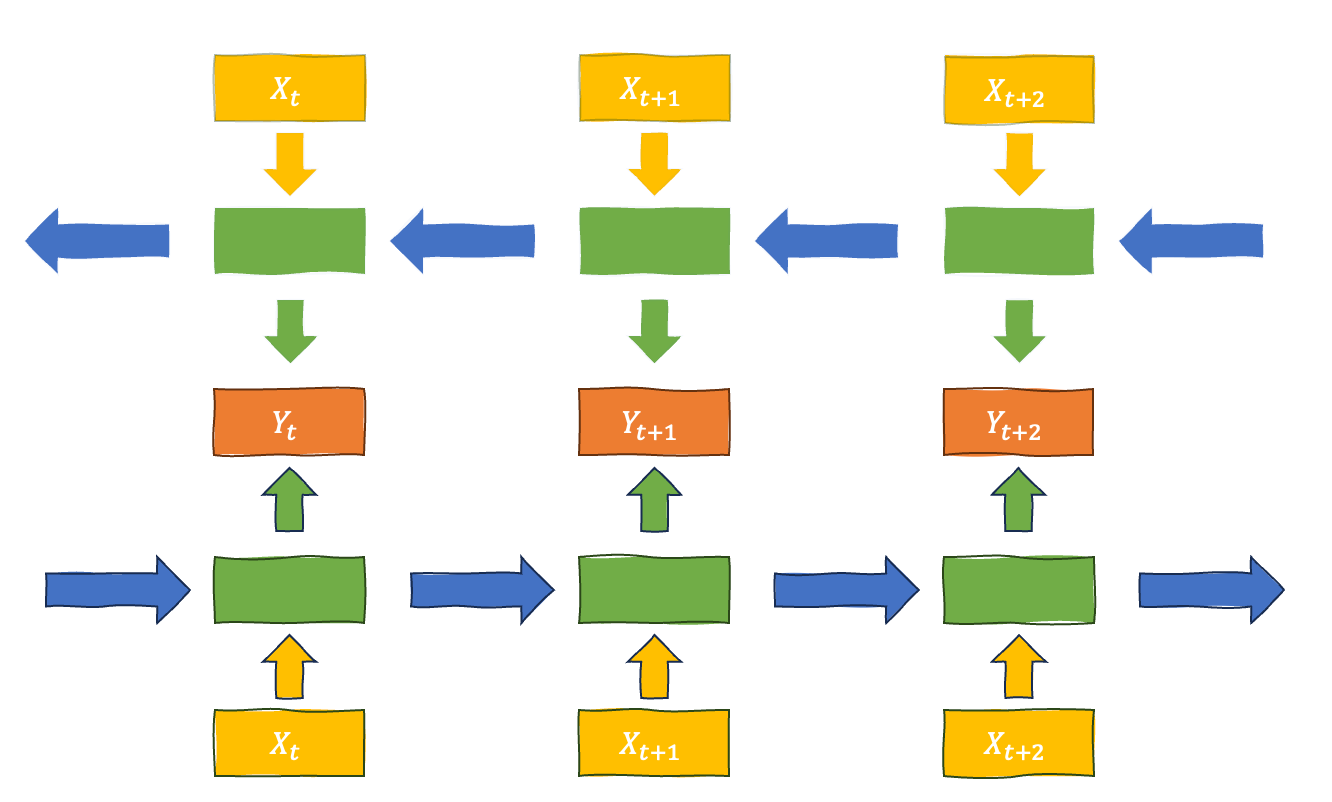
具体而言, 我们会训练两个方向的 RNN:
其中注意, 这里的 是两个不同的 hidden state, 它们的维度是相同的. 但是它们的权重矩阵和偏置项是不同的. 各自相当于是两个独立的 RNN. 训练完成后, 我们会将两个 hidden state 进行整合输出:
5. Machine Translation
-
机器翻译是一个典型的 Seq2Seq 任务, 其发展和 RNN 密切相关. 翻译中, 我们有一个 Source Language 和一个 Target Language, 两个 sequence 之间的长度, 以及每个 token 的位置等信息都是不一样的. 这样的问题也称为 Unaligned Sequence Problem.
-
这里以
Tatoeba数据集为例, 其数据集包含了多种语言的翻译对. 例如 English-French:# Go. Va! # Hi. Salut ! # Run. Cous! # Run! Courez !
5.1 Data Preprocessing
首先我们将数据集进行 tokenization:
src, tgt = data._tokenize(text)
# [['go', '.', '<eos>'], ...]
# [['va', '!', '<eos>'], ...]- 这里
<eos>是一个特殊的 token, 用来表示 end of sequence. - 为了进一步简化计算, 将稀有的 token 进行合并统一记为
<unk>.
5.2 Loading Sequence Data of Same Length
我们希望把每个 sequence 的长度都统一为 , 这样可以方便我们进行 batch 训练. 这里我们可以使用 pad_sequence 来实现. 具体而言其会通过 <pad> token 来填充每个 sequence, 使得每个 sequence 的长度都为 .
此外, 在针对 target sequence 的时候, 我们会在每个 sequence 前面加一个 <bos> token 来表示开始, 并且标记了 target.
5.3 Machine Translation 的 Encoder-Decoder 结构
对于机器翻译, 我们会使用一个 Encoder-Decoder 的结构. 其结构如下:
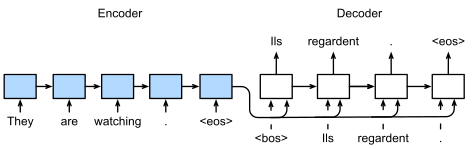
- Encoder: 将输入的 source sequence 进行编码, 得到一个 hidden state .
- Decoder: 将 hidden state 进行解码, 这个 hidden state 会被传入到 decoder 的每一个时间步中, 并联合 Target sequence 的上一个 token 作为输入, 进行解码预测. 模型在看到
<bos>token 后, 会开始进行预测, 直到预测到<eos>token.
Teacher Forcing: Teacher forcing 会使用真实的 target token 作为输入 (当然是前移一个位置), 而不是使用模型预测的 token 作为下一个输入. 这样可以加快模型的收敛速度, 但是在测试时, 我们需要使用模型预测的 token 作为下一个输入.
5.3.1 Encoder
具体而言, 假设输入的序列为
使用如下的公式进行编码:
我们还会引入一个 context vector 来表示当前的 hidden state (一般是最后一个步骤对应的):
Encoder 的训练权重有两个参数:
- No. of rows:
vocab_size, 表示输入的 token 的个数. - No. of columns:
embed_size, 表示每个 token 的 embedding 维度.
5.3.2 Decoder
在训练阶段, 我们希望 Decoder 能够和给定的 target sequence 进行对齐. 具体而言, Decoder 会输入三个变量: 上一步的 target token , 上一步的 hidden state , 以及 Encoder 的 context vector :
然后我们通过全连接层和 Softmax 层来进行预测:
5.3.3 Prediction
在预测阶段, 我们只有输入序列, 并不知道 target sequence. 在预测时, 我们永远会从 <bos> token 开始进行解码,直到遇到 <eos> token 为止. 并且此时我们会用预测的 token 作为下一个输入.
在理想状况中, 我们的目标是使得生成的 sequence 的联合概率分布最高:
-
Exhaustive Search: 想要枚举每一种可能进行计算是不现实的, 因为每一步我们都要从 个 token 中进行选择, 这会导致总的计算为 .
-
Greedy Search: 在 Greedy Search 中, Decoder 会通过 Softmax 生成一个概率分布, 每一步会选择最高的概率对应的 token 作为输出, 直到遇到
<eos>token 为止.- 然而 Greedy Search 并不保证能够收敛到全局最优.
-
Beam Search:
- 在每个时间步, 选择出现概率最高的 个 token 作为候选; 在生成的所有下一步的候选中, 再次选择 个 token 作为候选, 直到遇到
<eos>token 为止. - 在得到所有的候选后, 通过
- Beam Search 的时间复杂度
- 在每个时间步, 选择出现概率最高的 个 token 作为候选; 在生成的所有下一步的候选中, 再次选择 个 token 作为候选, 直到遇到
5.3.4 BLEU
引入 BLEU (Bilingual Evaluation Understudy) 来评估翻译的质量 (此时假设我们是有标准答案的). BLEU 是一个基于 n-gram 的评估指标, 其计算方式如下:
- 其中 是 n-gram 的精确度, 其计算方式如下:
- , 表示在 target 和prediction 中的 token 数量
- 是能够匹配到的最大 n-gram 的长度 (因为如果到 -gram 时已经没有能够匹配到的模式了, 那么对于所有的 的 n-gram 都是 0. 我们需要避免将0引入乘积中).
下面以 A,B,C,D,E,F 作为 target, A,B,B,C,D 作为 prediction 为例对 BLEU 的计算进行说明.
- 首先计算 n-gram precision:
- 1-gram : 分母考察 prediction 中总的 1-gram 数量, 这里是5. 分子为依次遍历 target 的每个 1-gram, 看是否能够匹配到 prediction 中的 1-gram. 这里是 4 (因为 target 中只有一个
B, 因此对于 prediction 中的第二个B不会进行匹配). 因此 . - 2-gram : 分母考察 prediction 中总的 2-gram 数量, 这里为
AB,BB,BC,CD共4 个. 分子为使用 target 的AB,BC,CD,DE,EF与 prediction 的 2-gram 进行匹配, 这里一共有 3 个匹配. 因此 . - 3-gram : Prediction 的 3-gram 为
ABB,BBC,BCD, 共 3 个. Target 的 3-gram 为ABC,BCD,CDE,DEF, 共 4 个. 这里 prediction 中的BCD和 target 中的BCD匹配, 因此 . - 4-gram : Prediction 的 4-gram 为
ABBC,BBCD, 共 2 个. Target 的 4-gram 为ABCD,BCDE,CDEF, 共 3 个. 这里没有匹配, 因此 .
- 1-gram : 分母考察 prediction 中总的 1-gram 数量, 这里是5. 分子为依次遍历 target 的每个 1-gram, 看是否能够匹配到 prediction 中的 1-gram. 这里是 4 (因为 target 中只有一个
- 然后计算长度惩罚项:
- , , 因此 .
- 此时, 因为 .
若 prediction 和 target 是完全相同的, 则所有 , 对应的 BLEU 为 1. 并且能够参与匹配的 n-gram 越长, 则 BLEU 越高. 前面的惩罚项是为了避免模型输出的长度过短, 使得 BLEU 过高.