References
- Reading: Dive into Deep Learning (D2L), Recurrent Neural Networks
1. Working with Sequences
RNN 等架构是为了处理序列数据而设计的. 往往这类任务的序列长度是不固定的, 例如自然语言处理, 语音识别, 时间序列预测等. 整体而言有三种形式:
- 输入固定长度, 预测不定长序列
- 输入不定长序列, 预测固定长度
- 输入输出都是不定长序列 (Sequence-to-Sequence). 具体而言有两种情况:
- Aligned: 每个步骤的输入顺序对应输出顺序
- Unaligned: 每个步骤的输入输出顺序不一定对应
- 如: 英文的 Go to school 在日语中可能是 学校に行く (学校: school, 行く: go), 其主语和动词的顺序是不一样的.
RNN 的研究和 NLP 的发展是相辅相成的.
模型的输入是一个序列 , 其中 表示第 个时间步的输入. 我们可以认为这个序列是独立得到的, 但是对于序列中的每个元素往往是有关联的. 因此我们往往会联合的考虑整个序列的密度分布:
即尝试着去建模得到这个序列的联合概率分布.
1.1 Autoregressive Models
在详细讨论 RNN 之前, 我们先来看一个简单的处理序列数据的模型: Autoregressive Models.
假设我们有一组数据 , 我们希望预测下一个时间步的数据 . 一个简单的模型是 Autoregressive Model:
即我们希望通过历史数据来预测下一个时间步的数据, 而 autoregressive model 就是指用自己往期的数据来回归预测自己的未来数据.
朴素的 autoregressive model 的一个问题是, 对于每个时间步骤, 数据的长度是变化的.
- 因此我们需要固定输入的长度, 例如只考虑前 个时间步的时间窗口 (window) 的数据, 而忽略掉更早的数据.
- 需要注意: 如果我们一共有 个时间步, 时间窗口的大小为 , 那么我们一共有 个可用的时间窗口 (examples) 来训练模型.
- 例如: 对于一个长度为 1000 的时间序列, 取 , 那么我们一共有 996 个时间窗口来训练模型: .
- 需要注意: 如果我们一共有 个时间步, 时间窗口的大小为 , 那么我们一共有 个可用的时间窗口 (examples) 来训练模型.
- 另一种方法是 Latent Autoregressive Model. 具体而言, 我们通过引入一个 latent variable 来概括截止到时间步 的全部历史信息, 即 . 这样我们就可以通过 来预测 .
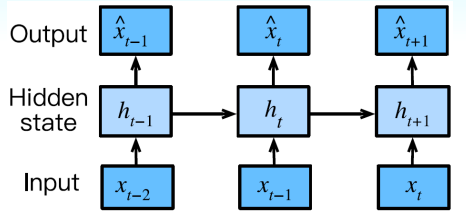
Language Models
在具体生成训练数据的时候, 我们往往就会通过随机抽取时间窗口的方式来生成数据. 又由于序列数据和 NLP 的关系, 我们往往将 seq models 也称为 language models, 即使真实的数据并不是文本数据.
一般来说, Language Models 希望模型能够学习到数据的联合分布:
1.2 Markov Models
对于一个离散的序列数据, autoregressive model 的本质是一个概率分类器. 而在对于上述的联合分布, 我们可以通过马尔科夫假设来简化模型: 对于例如 的预测, 我们不需要考虑所有的历史数据, 只需要考虑最近的 个时间步的数据 即可 (也称这样的 Markov 假设为 -th order Markov model, 即 阶马尔科夫模型).
一个特殊的情况是一阶马尔科夫模型, 即 , 此时 , 故:
1.3 Prediction
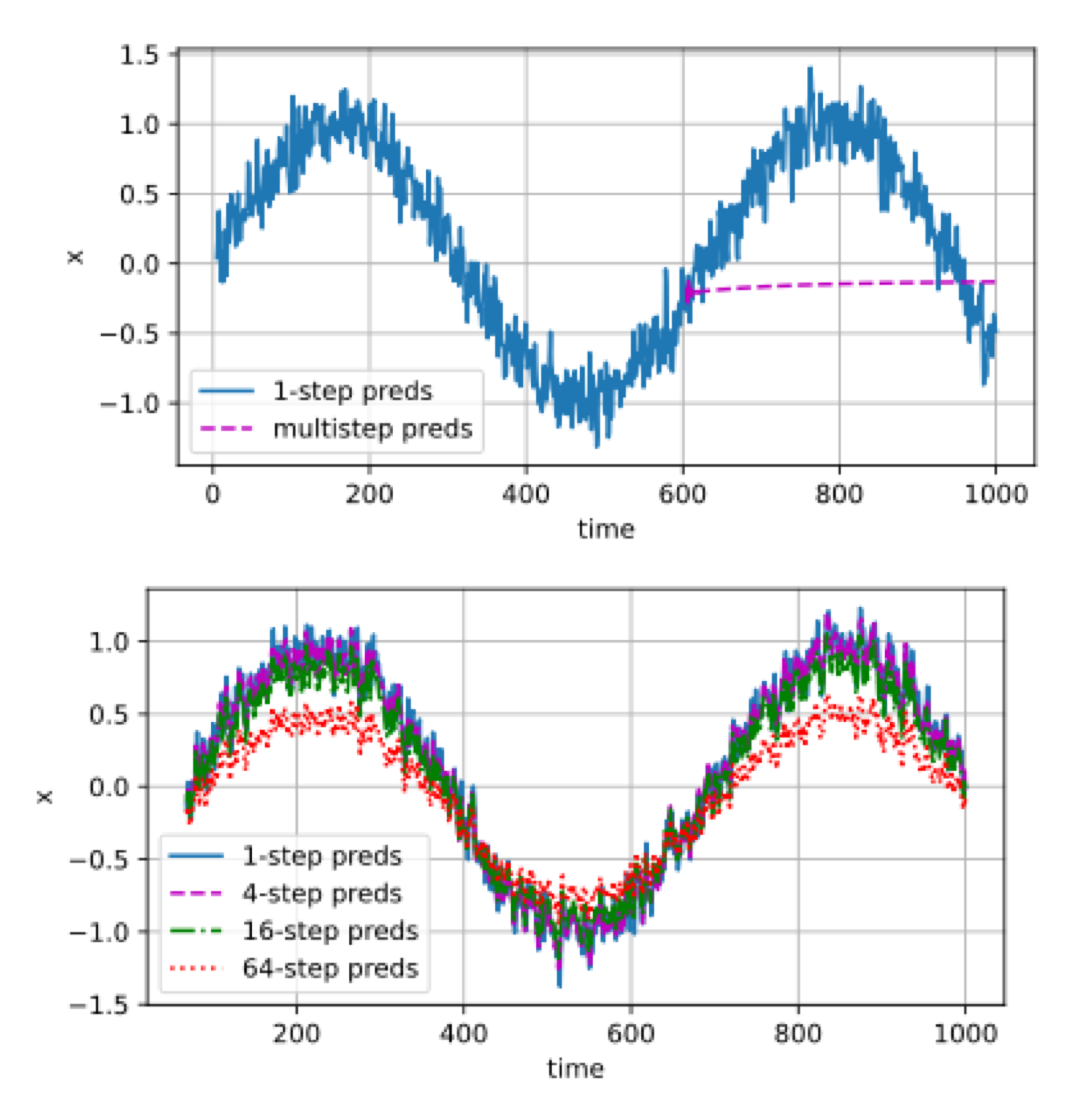
在预测时, 我们可能进行多 () 步向前预测. 即通过已知的历史数据 来预测 . 如果我们预测的时间过于遥远, 我们可能没有足够的历史数据来预测未来的数据. 在预测时对于无观测的数据, 我们可以用模型的预测值来代替. 但是这样会使得预测的误差逐渐累积.
2. Converting Raw Text into Sequence Data
在 NLP 中, 我们往往需要将原始的文本数据 (string ) 转换为序列数据. 我们可以通过以下步骤 preprocess 原始文本数据为序列数据:
- 将文本数据载入内存
- 预处理(raw text preprocessing): 去除特殊字符, 转换为小写, 去除标点符号, 去除停用词 (如冠词等虚词)/稀有词等.
- 分词 (tokenization): 将文本数据分割为单词或者子词. 有时还会加入一些特殊的 token, 例如
<unk>(unknown word),<pad>(padding),<bos>(beginning of sentence),<eos>(end of sentence) 等. - 建立词典: 将分词后的单词映射为整数 index
- 将文本数据转换为整数序列
2.1 Exploratory Language Statistics
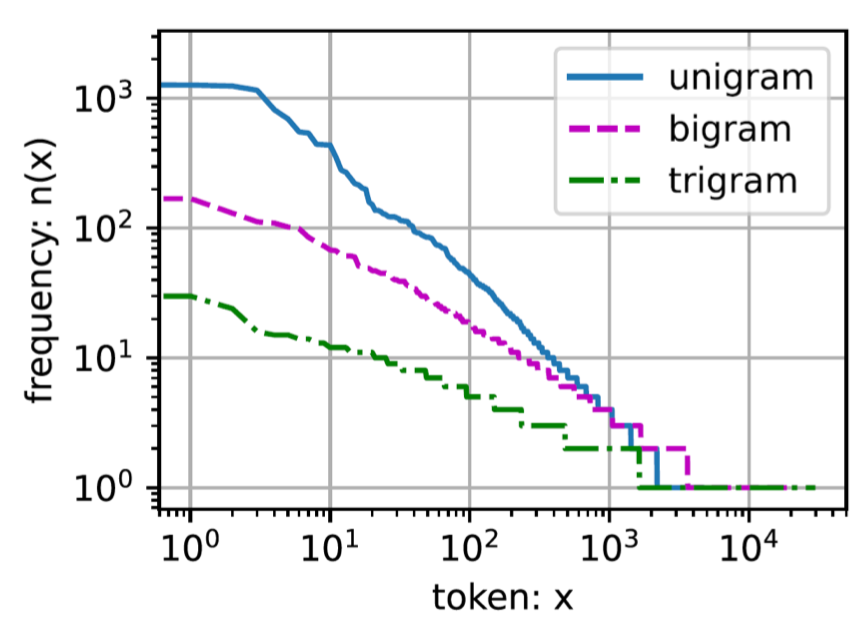
- 一个观察是, 词频的常用程度是一个长尾分布 (Zipf’s law) 或者幂律分布 (power law). 即有少量的词出现频率很高, 而大部分的词出现频率很低.
3. Language Models
回顾, 我们有数据 , 我们希望建模概率分布 , 并且按照这个分布来生成数据: .
我们往往会利用 Markov 假设来简化模型, 不同 order 的 Markov model 会对应不同的 N-gram model:
- Unigram Model / 零阶 Markov Model:
- Bigram Model / 一阶 Markov Model:
- Trigram Model / 二阶 Markov Model:
3.1 Word Frequency for Language Models
一个比较简单的对概率的具体建模是通过词频来建模. 即:
其中 表示 和 在数据中同时出现的次数, 表示 出现的次数. 这个模型很简单, 但是在实际应用中往往效果不好. 因为随着 N-gram 的长度增加, 数据中出现的 N-gram 的数量会急剧减少, 从而导致很多 N-gram 的概率为 0.
因此我们需要更加复杂的模型来建模概率分布, 故引出了 RNN.
4. Recurrent Neural Networks
RNN 沿用了 latent autoregressive model 的思想, 通过引入一个 hidden state 来概括选定时间窗口的历史信息. 具体而言, 我们有:
因此我们需要维护这样一个 hidden state 来概括历史信息:
对于一个足够复杂的模型 , 我们认为 甚至可以完美概括截止到时间步 的全部历史信息. 采用了 hidden state 的 RNN 由于 NLP 的发展在 2010s 年代得到了广泛的应用.
下面具体给出 RNN 的数学表达.
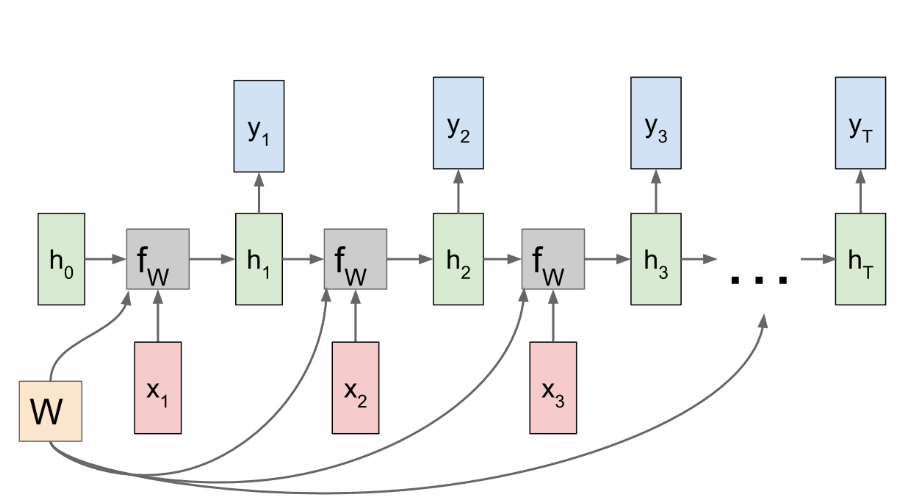
令 表示第 个时间步的 mini-batch 输入数据, 表示第 个时间步的 hidden state. 我们计算 hidden state 的方式为:
其中 是激活函数, , , 分别是输入到 hidden state 的权重矩阵和偏置向量. 每个时间步我们都是通过重复这一过程来更新 hidden state, 这也是 Recurrent 的由来.
在得到 hidden state 后, 我们可以通过一个输出层来预测下一个时间步的数据:
其中 , 分别是 hidden state 到输出层的权重矩阵和偏置向量.
同时, RNN 模型也是一个非常 parsimonious 的模型, 因为其参数的数量是固定的, RNN 中的参数是权重共享的, 在每个时间步我们都是用相同的权重矩阵来更新 hidden state.
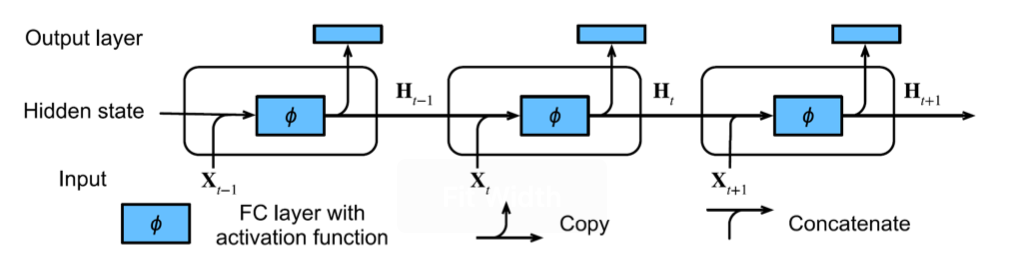
[?] Training 的时候使用上一步的结果还是data 的结果
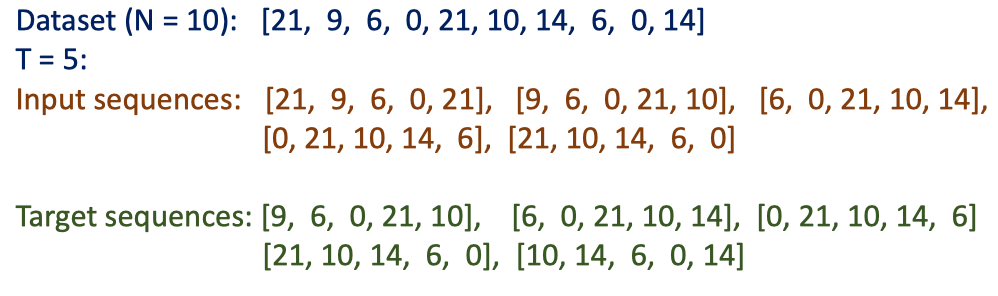
在 Language Model 的实践中, Dataset, input sequence 和 output sequence 的关系为:例如我们的输入是 , 对应label就是 , 以此类推. 例如:
4.1 RNN-based Language Models
这里以 character-level RNN-based language model 为例, 其输入是一个字符序列, 输出是下一个字符的概率分布. 以单词 machine 为例, 一个简化的 RNN 结构如下:
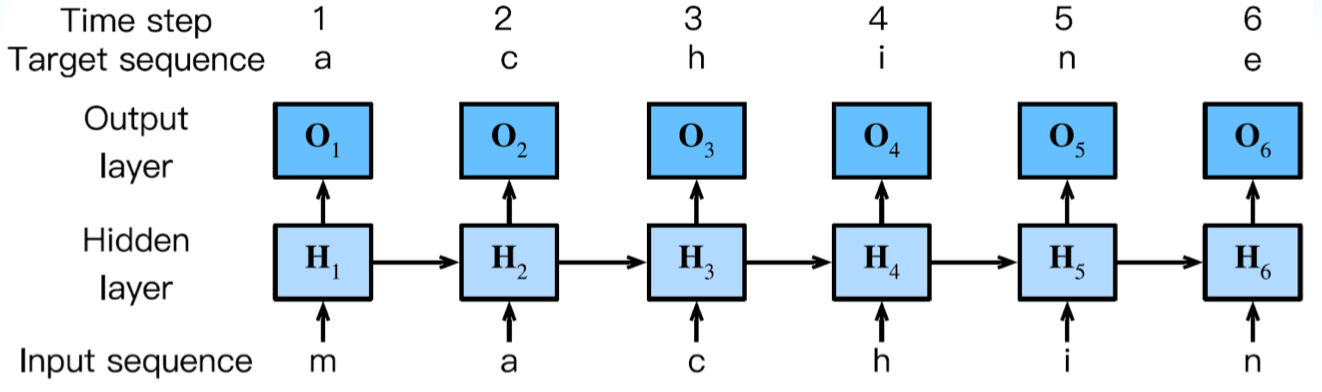
在训练时, 我们通过 Softmax 以把每个时间步中 output layer 的结果转换为概率分布, 并且用 cross-entropy loss 来计算模型的损失.
! 事实上 one-hot 并不是最好的输入方式 (其与index 等价, 都是一种稀疏表示). 在后面还会介绍 word embedding 的方式来表示输入.
5. Gradient Clipping (梯度裁剪) ?
RNN 也是一种深度神经网络, 尽管其权重共享的机制并不像 MLP 一样会有许多层, 但是其在时间意义或 gradient flow 的角度上, 也是一个深度网络 (). 因此在训练时, 我们也需要考虑梯度消失/爆炸的问题.
为了解决 RNN 的梯度爆炸问题, 一个简单的方法是梯度裁剪 (Gradient Clipping). 粗略地说, 我们需要强制 gradient 的范数不超过一个阈值 .
其中 是梯度, 是学习率.
为了理解梯度裁剪的原理, 这里考虑一个足够光滑的目标函数 , 使得对于任意 Lipschitz 常数 (该常数只取决于 ), 满足:
(该条件保证了的Lipschitz连续性). 当我们用 GD 更新参数时 (即取 ) 有:
因此我们得到了一个目标函数的更新幅度的上界 .
- 这个上界如果过小, 则算法收敛过慢
- 如果过大 (当 过大), 则可能导致 gradient explosion. 我们便浪费了大量的计算资源在更新参数上, 并且最终的结果可能会发散, 或在一个不稳定的状态上震荡.
为了解决这个问题:
- 一个直观的想法是通过控制学习率 来控制 的大小. 但是这并不能本质上解决这个更新的 bias, 而只是减缓了梯度更新的速度.
- 更理想的方法是 gradient clipping, 即尝试控制梯度 的取值. 具体而言, 我们在更新参数之前, 先计算梯度及其范数, 如果梯度的范数超过了阈值 , 我们就将梯度的范数缩放到 : 这样我们就保证了梯度的范数 .
6. Perplexity (困惑度)
Perplexity 是一种用来评估语言模型的指标, 衡量一段文字的”surprisingness”. 例如我们有如下三种对于 “It is raining” 的预测:
- Model 1 - “It is raining outside” : 最优情形
- Model 2 - “It is raining bananas” : 次等情形
- Model 3 - “It is raining lkjljfa” : 最次情形
一种想法是计算一个句子的似然函数, 但是该似然值会受到句子长度的影响. 因此或许一个更好的方法是计算模型成功预测下一个 token 的准确率. 具体而言, 参考预测的交叉熵:
其中 是模型预测第 个 token 的概率.
对该指标取指数, 我们得到了 perplexity:
Perplexity 可以理解为 “当模型每次进行决策一共正确的选项的次数的几何平均值”.
- 最优情形下, 模型能够准确预测下一个词, 预测概率为 1, 因此 perplexity 为 1.
- 最次情形下, 模型预测的概率为 0, 因此 perplexity 为 .
- Baseline 情形下, 模型的 perplexity 为 (词典的 token 个数). Baseline 假设模型会均匀随机的选择一个 token. 因此对于一个没有任何信息的模型, perplexity 为 . 故正常的一个模型的 perplexity 应该小于 .