References
- Lecture: 李宏毅.
- Case Study: DeepSeek-R1.
1. How Do DeepSeek-R1 Style Models Perform Deep Reasoning?
1.1 Introduction
在当下, 例如 ChatGPT o1/o3/o4, DeepSeek-R1, Gemini 2 Flash Thinking, Claude 3.7 Sonnet 等大型语言模型具有一定的长思考能力.
对于这类语言模型, 其深度思考具有一定模式:
- 首先在给定问题后, 不会直接回答, 而是会先在
<think> ... </think>之间进行思考, 最后根据思考结果回答. - 思考的主要内容可能包括:
- Verification: e.g. “Let me check the answer …”
- Explore: e.g. “Let’s try a different approach …”
- Plan: e.g. “Let’s first try to …”
在 LLM 语境下, 我们往往称这种思考为 reasoning, 注意要区分 inference.
相关概念:
- Test-Time Compute: 模型即使完成训练并进行 inference, 仍然会进行一系列复杂计算.
- Test-Time Scaling: 模型在 inference 时投入更多计算资源往往会带来更好效果.
- Scaling Scaling Laws with Board Games 研究了计算资源应投入到训练过程, 如训练更大的 policy network, 还是推理过程, 如使用更大的 Monte Carlo Tree Search. 其发现少量 test-time compute 投入可以减少大量训练资源投入.
让模型具有 reasoning 能力, 目前有几种方法:
- 更强的 Chain of Thought (CoT), 不需要微调.
- 给模型 reasoning 的工作流程, 不需要微调.
- Imitation learning, 教模型 reasoning 的工作流程, 需要微调.
- 以结果为导向学习 reasoning, 需要微调.
2. Better Chain of Thought
Chain of Thought (CoT) 是一种让模型在进行推理时, 先列出思考过程, 然后再给出最终答案的方法. 其在 2022 年被提出, 有两种主要形式.
2.1 Few-Shot CoT
Few-shot CoT 在给定的 prompt 中, 在提问之前先给模型提供一些问答范例, 其中回答过程包含 CoT.
Example:
Q: Roger has 5 tennis balls. He buys 3 more cans of tennis balls. Each can has 4 balls. How many tennis balls does Roger have now?
A: Roger started with 5 tennis balls. He bought 3 cans of tennis balls, and each can has 4 balls. So he bought 3 * 4 = 12 more tennis balls. Now he has 5 + 12 = 17 tennis balls.
Q: A juggler can juggle 16 balls. Half of the golf balls are red. How many red balls does the juggler have?
A:
2.2 Zero-Shot CoT
Zero-shot CoT 只给出问题, 不提供范例. 研究发现仅仅让模型 “think step by step” 就可以让模型进行 CoT 推理.
Example:
Q: A juggler can juggle 16 balls. Half of the golf balls are red. How many red balls does the juggler have?
A: Let's think step by step.
在当下 reasoning 研究中, 有时也称之为 “Long Chain of Thought” (LoT), 把之前传统 CoT 称为 “Short Chain of Thought” (SoT).
进一步发现, 有时如果只是单纯告诉模型 “think step by step”, 其可能没有办法进行深度思考. 因此也有人提出 supervised CoT, 其在 prompt 中会一点一点告诉模型如何思考:
請仔細思考並詳細回答以下問題。在回答前,請先深入分析題目的要求,
訂出一個完整且清晰的解題計畫,明確列出你將如何分步完成這個問題。
在執行每一個主要步驟前,請再次訂出該步驟的子計畫,
仔細列出需要處理的細節,然後再按部就班地執行。
每執行完一個步驟或子步驟後,請進行多次驗算,
確保該步驟的答案絕對正確,並考量所有可能的解法。
若在驗算過程中發現問題,請立即回到該步驟重新訂定或調整計畫。
在進行以上過程時,務必將你詳細而完整的思考過程以及所有計畫、
子計畫、驗算步驟,全部置於"<think>"和"</think>"這兩個符號之間。

Q: 123 x 456 =
3. Giving Models a Reasoning Workflow
一个简单粗暴的思路是让模型尽可能多地进行 exploration. 当尝试次数足够多时, 其可能找到一个好的答案.
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling 发现对于数学问题, 让模型进行多次采样, 只要尝试足够多, 基本都可以找到正确答案. 更好的模型所需尝试次数往往更少.
However, exploration faces a selection problem: how do we pick the best answer?
- Majority Vote (Self-Consistency): 在所有模型出现的答案中, 选出出现次数最多的答案. Majority vote 往往表现很好, 是常见 baseline.
- Confidence Score: 让模型给出每个答案的置信度, 选出置信度最高的答案.
- Answer Verification: 引入另一个 verifier, 可能是另一个 LLM, 给每个答案评分, 选出 best-of-N 的答案. Verifier 也可以是通过 ground truth 数据训练的专用模型.
- Process Verification: 除了最终答案 verification, 也应当在思考中间过程进行验证. 在每一步思考中都给出 verifier, 只对通过验证的思考继续后面的思考.
- 一个实现方法是 in-context learning: 在 prompt 中明确指定模型一步一步输出
<step> ... </step>, 然后在每次发现</step>时让模型暂停生成并使用 process verifier 进行验证. - 可以使用 beam search, DVTS 等搜索方法来保留最优部分, 得到更好的答案.
- 一个实现方法是 in-context learning: 在 prompt 中明确指定模型一步一步输出

通常为了表达更清楚, 我们往往还会要求模型将最终答案进行格式输出, 放置在 <answer> ... </answer> 之间.
4. Imitation Learning: Teaching Reasoning Workflows
这相当于一种 post-training 方法: 让一个不会 reasoning 的 foundation model 进行微调, 让其学会 reasoning 的工作流程.
具体而言, 训练数据要包含 Input, Reasoning Process, Ground Truth 三个部分. 通过这样的数据对模型进行微调, 让其学会 reasoning 的工作流程. 其中一个非常重要的问题是: reasoning process 的数据应该如何得到?
- 一个直观做法是引入另一个模型, 让其给出 reasoning process 和 answer. 如果模型得到正确答案, 那么 reasoning process 也应该是正确的. 因此保留这样的 reasoning process 作为训练数据.
- 对于一些可能没有标准答案的问题, 也可以引入 verifier 来验证答案合理性, 以得到合理的 reasoning process.
rStar-Math: Small LLMs Can Master Math Reasoning with Self-Evolved Deep Thinking 研究了在推论每一步加入 verifier, 通过类似树状搜索的方法让模型在每一步都进行验证. 这样模型的 reasoning 过程可能更合理可靠.
另一个问题是: reasoning 的每一步一定必须正确吗? 换言之, 纠错或许也是 reasoning 的重要能力. 如果训练数据中的 reasoning process 一直是完美的, 模型可能并不会学会纠错能力, 这样 reasoning 时 robustness 可能会很差.
因此也许需要在 reasoning 过程中加入一些噪声, 得到一些有可能错误的 reasoning process, 并且提供回退和修正能力.
4.1 Knowledge Distillation
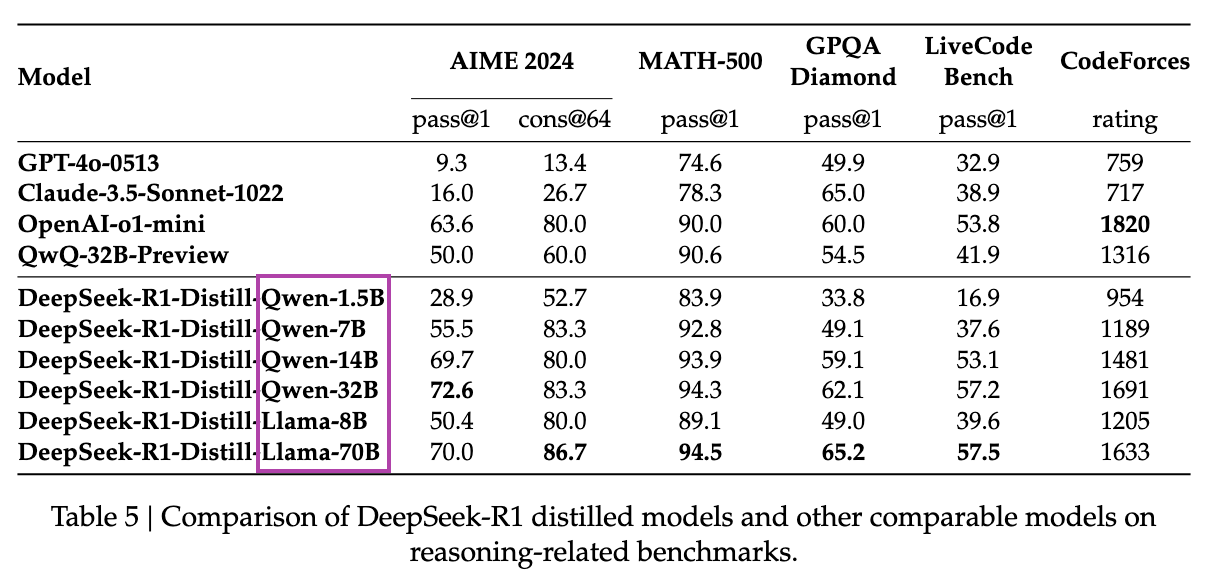
通过引入另一个模型来生成 reasoning process, 本质上就是知识蒸馏. 主要思路是: 有一个大型模型, 可以给出 reasoning process 和 answer. 然后通过这个大型模型指导一个小型模型进行 reasoning 工作流程.
DeepSeek-R1 论文中也指出, 通过知识蒸馏让小模型学习大型模型的 reasoning 工作流程, 可以得到更好的效果.
5. Learning Reasoning by Outcomes
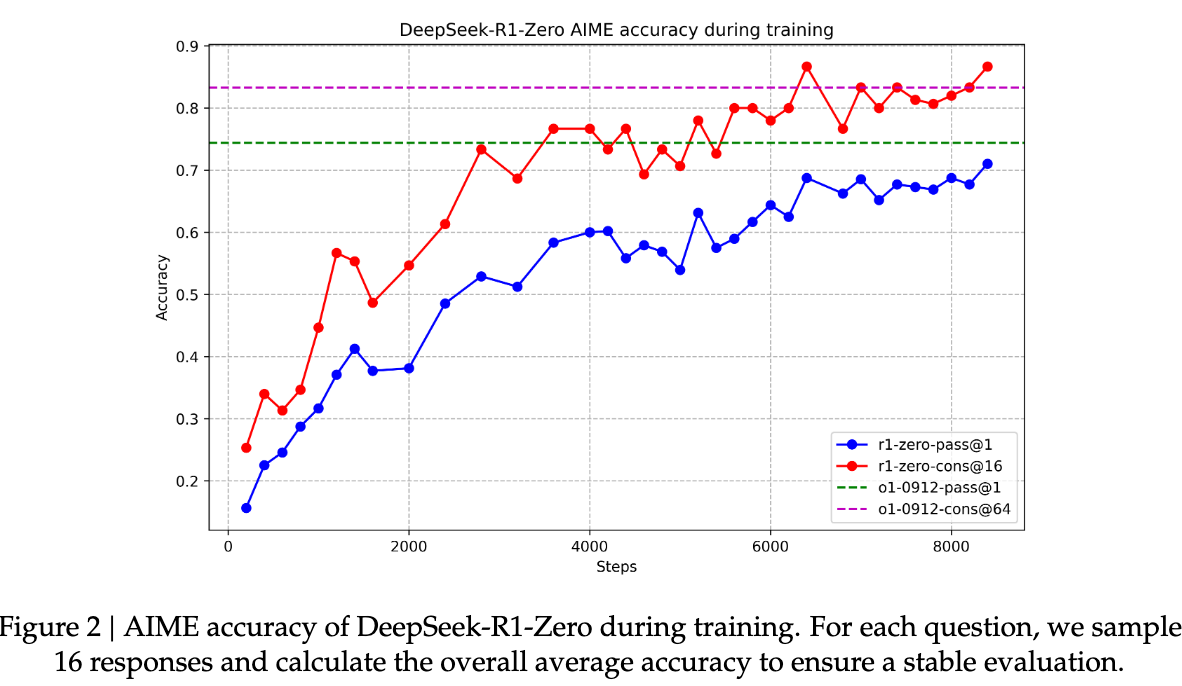
该方法的思路是 DeepSeek-R1 的主要训练思路. 核心思想是: 有一系列 Input + Ground Truth 训练数据, 让模型进行 reasoning 并给出最终答案. 如果答案正确就给正向奖励, 如果答案错误就给负向奖励. 不关注 reasoning 的具体内容, 只关注最终答案是否正确.
在 DeepSeek 中, 通过 DeepSeek-v3-base 作为 foundation model, 通过纯 RL 训练得到 DeepSeek-R1-Zero. 在 DeepSeek-R1 论文中, 即使是纯粹 RL 训练, 其在 reasoning 任务上也有很好的效果.
5.1 Aha Moment
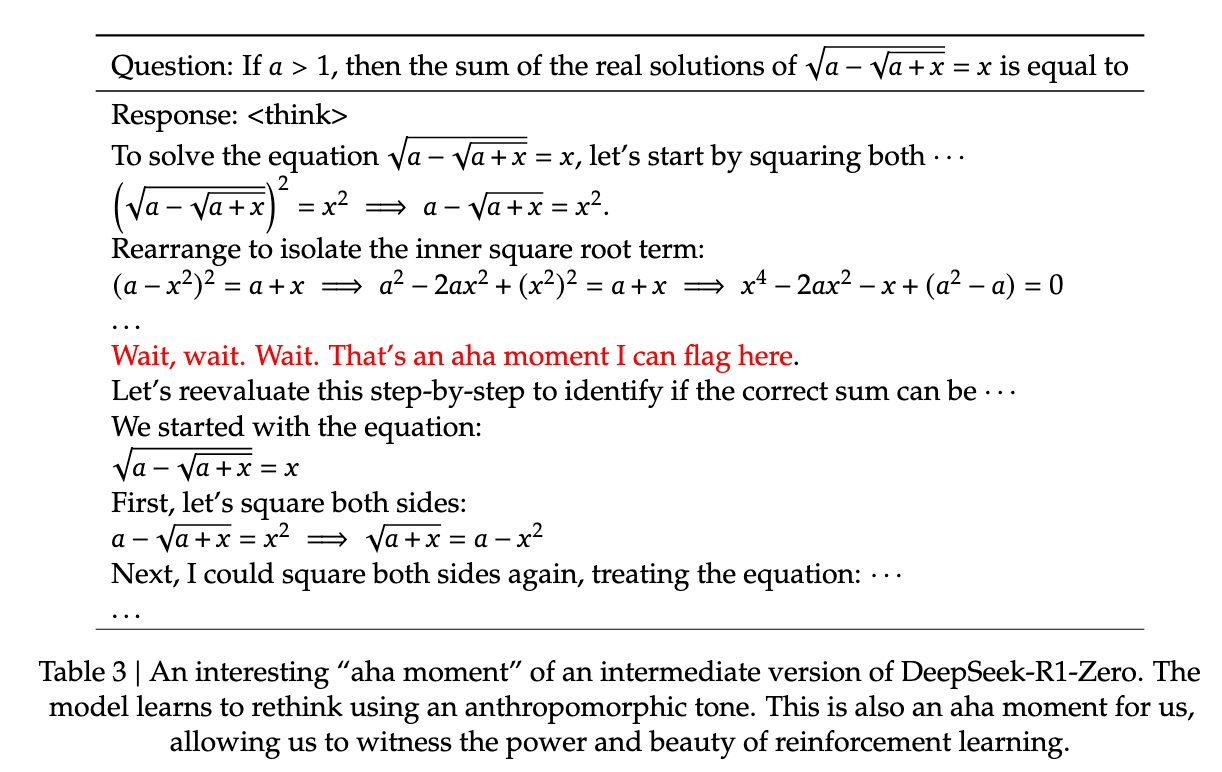
DeepSeek-R1 论文提出 Aha Moment 的概念, 指代模型在推理过程中突然产生纠错能力.
5.2 R1 Training Pipeline
DeepSeek-R1-Zero 虽然具有一定 reasoning 能力, 但并不是可以直接使用的模型. 其 reasoning 过程中由于只关注结果正确性, 可能包含多语言混杂等问题. DeepSeek 通过一系列手段对模型进行微调, 得到最终使用的 DeepSeek-R1.
- 得到 DeepSeek-R1-Zero 后, 用其生成 reasoning 过程, 并通过大量人工润色修订得到可用 reasoning 过程. 此外, DeepSeek 还通过 few-shot prompting with long CoT, directly prompting 等方法得到更多 detailed 数据, 约几千条.
- 利用这些 reasoning 数据, 对 DeepSeek-v3-base 进行 imitation learning 微调, 得到 Model A.
- 在 Model A 基础上额外进行 RL 训练. 除了正确率要求外, 还要求模型在 reasoning 过程中使用一致语言. 训练后得到 Model B.
- 使用 Model B 对一系列数据进行 reasoning, 得到许多 reasoning 数据和答案. 引入 DeepSeek-v3 作为 verifier, 对 reasoning 和答案评分, 最终得到新的 reasoning 数据集, 约 60 万条. 此外又让 DeepSeek-v3 进行 self-output 得到 20 万条数据混入其中以避免遗忘.
- 让 DeepSeek-v3-base 在约 80 万条数据上进行 imitation learning, 得到 Model C.
- 对 Model C 进行额外 RL 训练, 着重处理 safety 和 helpfulness, 得到最终 DeepSeek-R1.
Note: Unused methods
DeepSeek 也尝试使用了 MCTS 和 process verification 等方法, 但是没有最终使用.
5.3 Foundation Model Also Matters
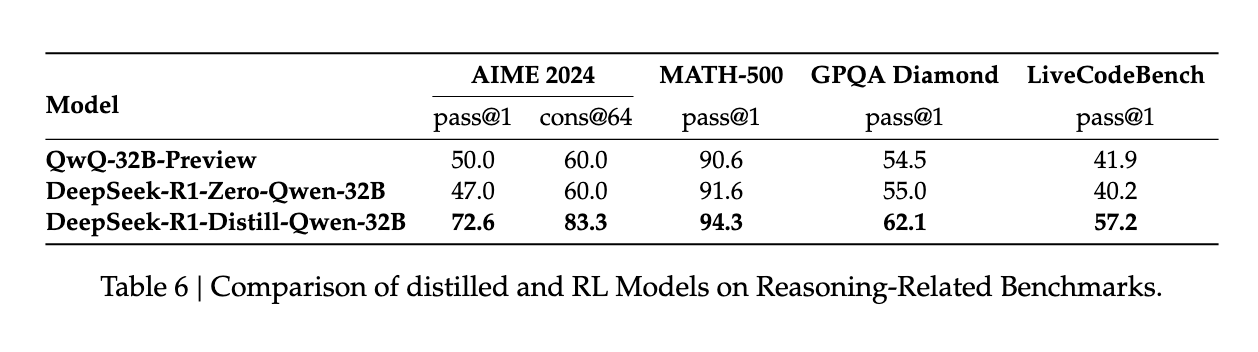
以 Qwen-32B-Base 作为 foundation model 进行 RL 的效果弱于以 DeepSeek-v3-base 作为 foundation model 的效果. 而直接通过 imitation learning 的方式进行 distillation 微调 Qwen-32B-Base 反而比较有效.
总而言之, RL 是强化模型原有的能力, 而不是创造新的能力.
因此 Understanding R1-Zero-Like Training: A Critical Perspective 等研究指出, DeepSeek-v3-base 在 RL 之前本来就具有 Aha 的能力, RL 只是强化了这个能力.