References
- Lecture: 李宏毅, 生成式 AI 時代下的機器學習 2025, 第五講: 大型語言模型訓練方法「預訓練-對齊」的強大與極限.
- Video: https://youtu.be/Ozos6M1JtIE?si=BonQW50Ef1m1KmYS
1. Three Stages of LLM Training
当前的 LLM 训练基本会分为三个阶段:
- Pretraining: 通过大量网络爬虫数据进行无监督训练, 进行 “文字接龙” 任务, 让模型学习语言的基本规律.
- Supervised Fine-Tuning (SFT): 通过人类标注的数据进行有监督训练, 让模型学习人类的意图.
- Reinforcement Learning from Human Feedback (RLHF): 通过人类反馈进行强化学习, 让模型学习人类偏好.
通常会将 SFT 和 RLHF 这两个需要人类参与的步骤统称为 alignment, 即对齐. 某种意义上, 这指的是我们希望模型的输出与人类意图一致. 有时也会和 fine-tuning 混用.
2. Does Pretraining Seem Useless?
- 在 LLM 中, 诸如 LLaMA-2-7b-base 这种以 base 为后缀的模型就是指经过 pretraining 但没有经过 alignment 的模型. 反过来, LLaMA-2-7b-chat 这种以 chat / instruct 等后缀的模型, 则是经过 alignment 的模型.
- 通常而言, 经过 alignment 的模型表现会远优于没有经过 alignment 的模型.
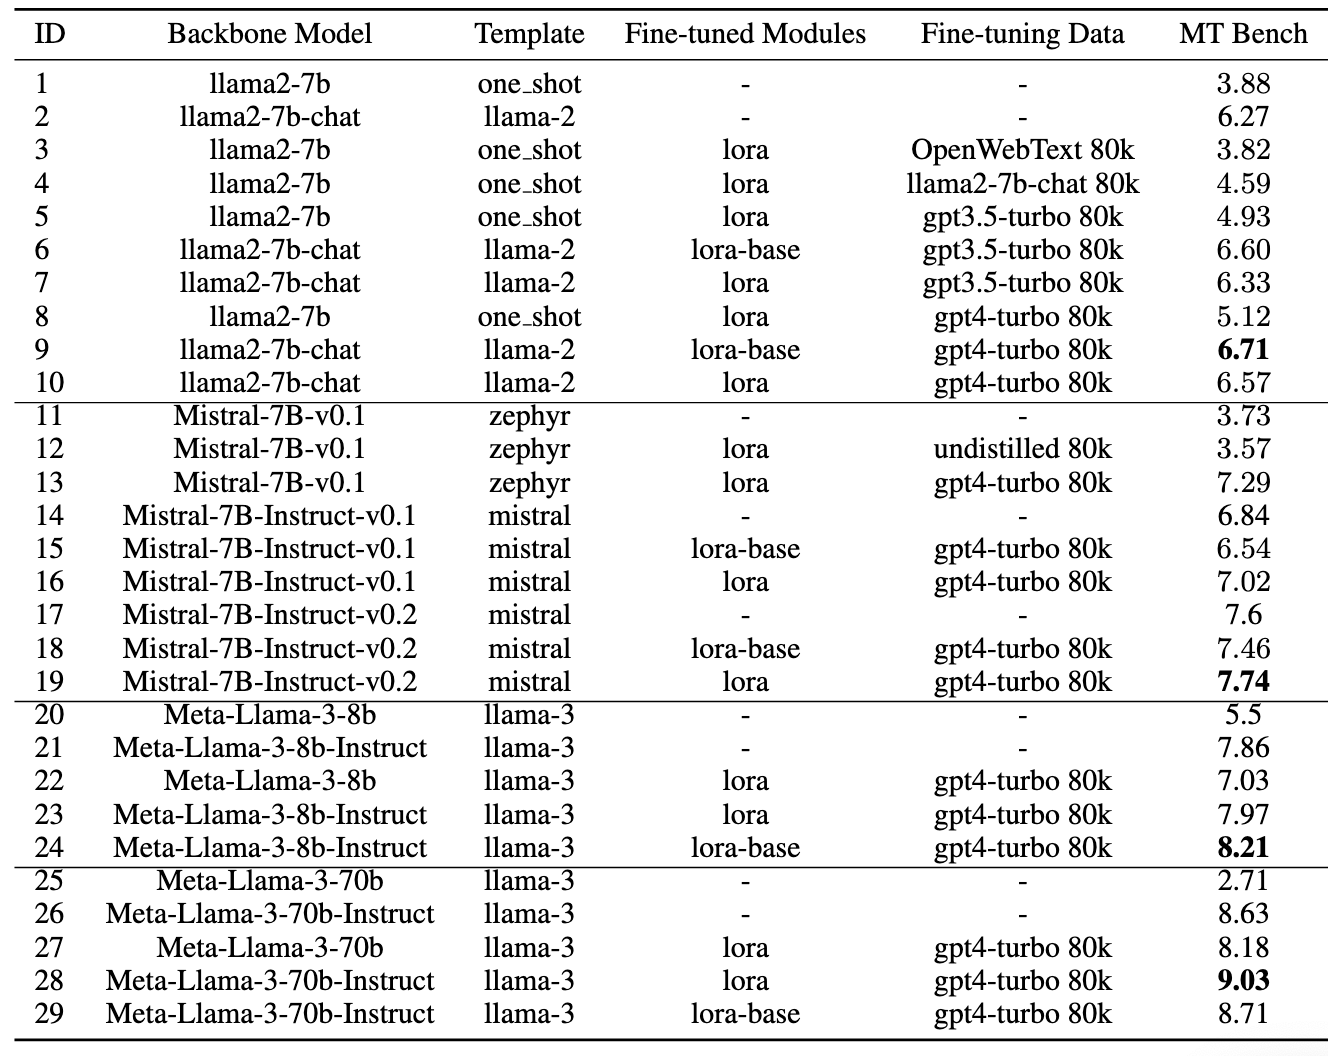
- 不过可能略违反直觉的是, 用于 alignment 的数据集通常是小规模的.
- 在 LLaMA 2 的 SFT 中, 其用到的数据只有 27540 条. 只经过 SFT 的模型就已经能够接近人类水平. Quality Is All You Need.
- LIMA: Less Is More for Alignment 也是使用小规模但高质量的 alignment 数据集, 经过 LIMA 的模型在一些任务上甚至超过了经过 RLHF 的模型.
3. Knowledge Distillation for Alignment
Knowledge distillation 在直觉上类似一种逆向工程. 其实质上是通过一个大模型作为 teacher model, 让一个小模型 student model 学习大模型的知识. 某种意义上这也是一种 alignment 过程.
这相当于我们会通过 SFT, RLHF 等方法来对齐一个大模型, 然后再通过知识蒸馏的方法间接地将这些对齐知识传递给一个小模型.
- Alpaca, Vicuna 等都是通过 ChatGPT 作为 teacher model, 让 LLaMA1-7B-base 知识蒸馏得来的.
- AlpaGasus 进一步通过 LLM 在 Alpaca 的训练资料中筛选高品质训练资料来进行知识蒸馏.
- Long Is More for Alignment 直接通过选择最长的资料来进行知识蒸馏, 效果也非常好.
Question (How should one choose knowledge distillation data?).
- Non-instructional Fine-tuning 认为, 只要是人类知识, 都可以用来进行知识蒸馏. 甚至在构建用来进行知识蒸馏的资料时没有选择问句, 而是直接从网络中搜索一个句子的截取上半段, 让 teacher model 预测下半句, 并让 student model 进行 alignment.
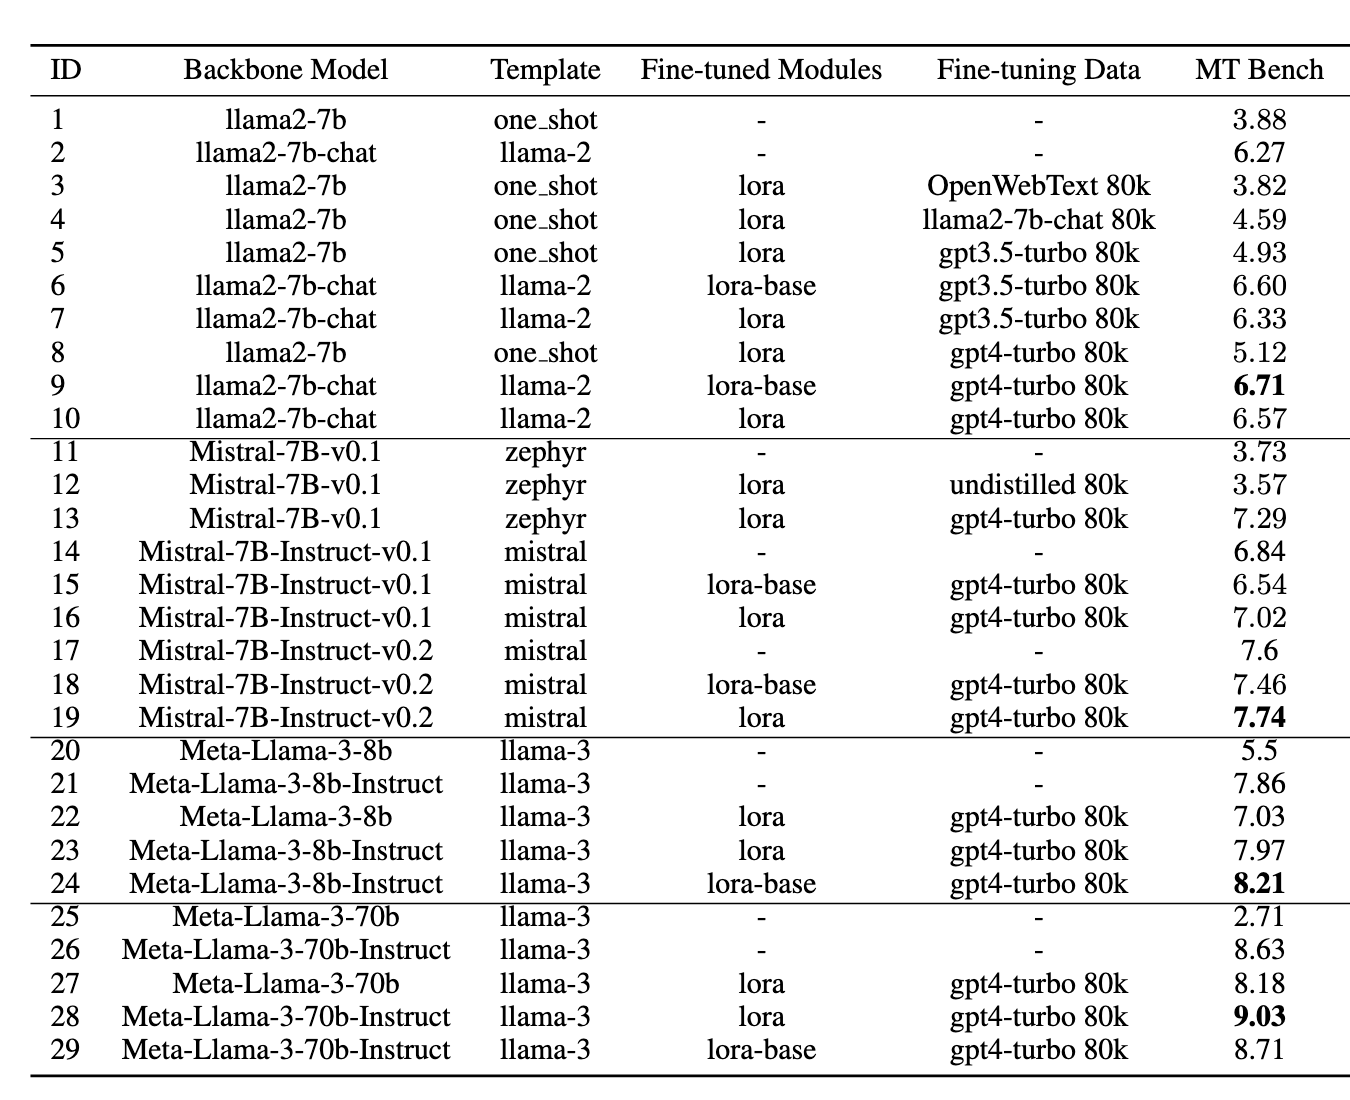
- 以上图实验 ID 11-13 为例. 如果用 Mistral-7B-v0.1 作为 base model, 在没有经过任何对齐的情况下, 其在 MT-Bench 上的表现为 3.73.
- 若只是单纯从网络上的句子进行截取, 前半段作为输入, 后半段作为答案进行微调, 其在 MT-Bench 上的表现为 3.57.
- 然而如果后半句话改为用 ChatGPT 针对输入前半段进行预测, 其在 MT-Bench 上的表现则提升为 7.29. 这甚至比 Mistral-7B-v0.1 经过 fine-tuning 得到的 Mistral-7B-v0.1-Instruct-v0.1 还要好.
4. Is Alignment Actually Easy?
-
The Unlocking Spell on Base LLMs 认为, 在经过 alignment 前后, 模型的实际行为差异并不大.
- Alignment 前后显著改变的都是一些连接词或并不改变真实语义的词.
-
Revealing the Inherent Instructability of Pre-Trained Language Models 提出 response tuning. 这种方法不会输入任何问题, 而是只使用 response 进行 fine-tuning.
-
Instruction Following without Instruction Tuning 通过强制模型的一些输出规则而没有进行任何 fine-tuning, 在一些任务上也能和 instruction 模型进行对比.
-
Self-Rewarding Language Models 提出 self-alignment 方法. 给定一个没有 alignment 的 LLM 模型, 其通过向模型提问得到一系列不同答案, 然后通过一些评分 instruction 让 LLM 自己给每个答案打分, 并反过来用这些评分对模型进行 RL 训练. 经过迭代, 模型表现也有一定提升.